
Własny sklep na 9 rynkach zamiast uzależnienia od marketplace
Klient: Global Parts
Branża: Motoryzacja / Mobility
Codziennie korzystamy z wyszukiwarek – czy to w internecie, czy w firmowych bazach wiedzy – oczekując szybkiego i trafnego dostępu do informacji. Tradycyjne metody oparte na słowach kluczowych często zawodzą, bo nie rozumieją kontekstu ani intencji użytkownika. Rozwiązaniem tego problemu stało się Embedding-Based Retrieval, czyli inteligentne wyszukiwanie oparte na wektorowych reprezentacjach danych.

CEO
28 wrz 2025
Wyszukiwanie informacji towarzyszy nam każdego dnia – od korzystania z Google, przez przeszukiwanie firmowych baz wiedzy, aż po aplikacje mobilne. Klasyczne metody wyszukiwania opierają się głównie na dopasowaniu słów kluczowych, co w wielu przypadkach okazuje się niewystarczające. Użytkownik może użyć innego słowa niż autor dokumentu, a mimo że treść jest merytorycznie zgodna z zapytaniem, system jej nie zwróci. W odpowiedzi na te ograniczenia powstały nowoczesne techniki oparte na sztucznej inteligencji, które pozwalają systemom rozumieć znaczenie zapytań, a nie tylko ich brzmienie. Jednym z kluczowych rozwiązań w tym obszarze jest właśnie Embedding-Based Retrieval, czyli wyszukiwanie bazujące na wektorowych reprezentacjach danych.
Klient: Global Parts
Branża: Motoryzacja / Mobility
Klient: Dr Marcus
Branża: Motoryzacja / Mobility
Embeddingi to matematyczne reprezentacje obiektów – takich jak słowa, zdania, obrazy czy dźwięki – zapisane w postaci wektorów w przestrzeni liczb. Ich głównym celem jest uchwycenie znaczenia i kontekstu, a nie tylko powierzchownej formy. Na przykład słowa „pies” i „kot” będą miały wektory położone blisko siebie, ponieważ odnoszą się do podobnych pojęć, podczas gdy „pies” i „samochód” znajdą się znacznie dalej w przestrzeni wektorowej. Dzięki temu komputer może „rozumieć” relacje semantyczne i wyszukiwać treści nie tylko na podstawie dokładnego dopasowania znaków, lecz także sensu zapytania. Embeddingi tworzy się za pomocą modeli uczenia maszynowego, które analizują ogromne zbiory danych i uczą się reprezentować znaczenia w formie, którą systemy informatyczne potrafią szybko przetwarzać.
Tradycyjne wyszukiwanie opiera się na dopasowaniu słów kluczowych – system sprawdza, czy w dokumencie występuje dokładnie ten sam wyraz, którego użył użytkownik. Problem w tym, że język naturalny jest pełen synonimów, skrótów i różnych sposobów wyrażania tej samej myśli. Jeśli ktoś wpisze hasło „auta elektryczne”, a dokument zawiera frazę „samochody na prąd”, klasyczna wyszukiwarka może go pominąć. W podejściu embeddingowym ten problem znika, ponieważ system analizuje znaczenie zapytania i odnosi je do treści w bazie wiedzy. Dzięki temu wyszukiwarka semantyczna potrafi kojarzyć różne sformułowania, a użytkownik szybciej dociera do informacji, których naprawdę potrzebuje – nawet jeśli nie użył tych samych słów, co autor treści.
Proces wyszukiwania opartego na embeddingach można podzielić na kilka kluczowych etapów. Najpierw dokumenty źródłowe (np. artykuły, e-maile, pliki PDF) są przetwarzane przez model językowy, który zamienia je na wektorowe reprezentacje – embeddingi. Każdy dokument lub jego fragment otrzymuje unikalny wektor, który opisuje jego znaczenie w przestrzeni liczb.
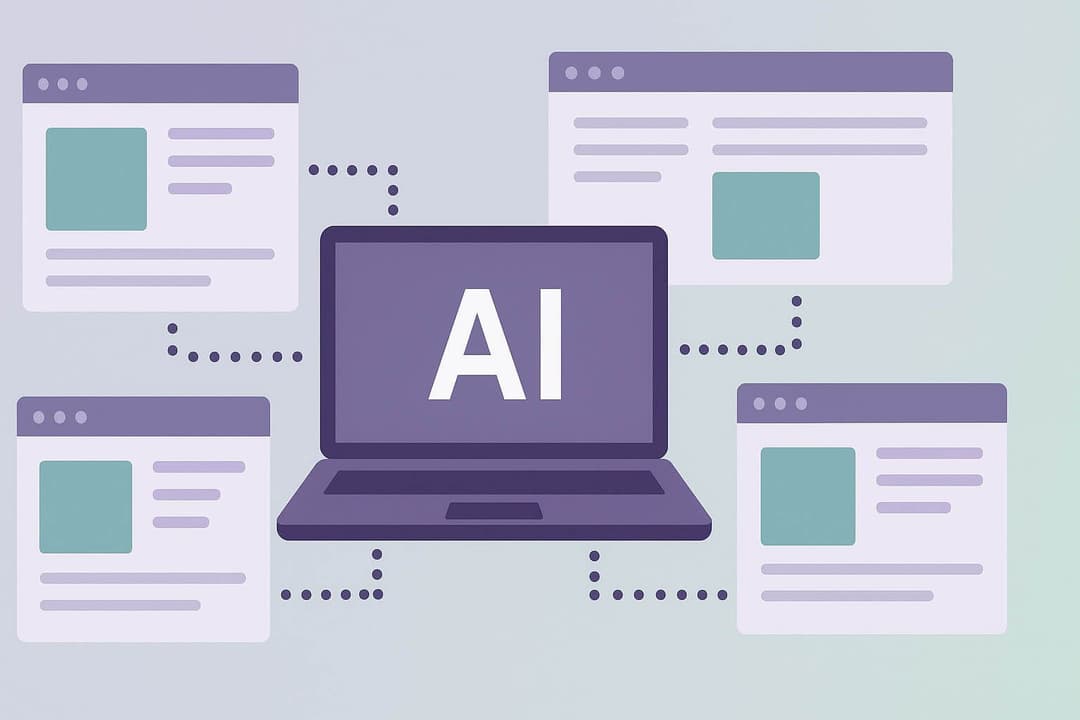
Kiedy użytkownik wpisuje zapytanie, system wykonuje tę samą operację – zamienia pytanie na embedding. Następnie porównuje wektor zapytania z wektorami dokumentów zapisanymi w bazie. Najczęściej stosowaną metodą jest obliczanie podobieństwa kosinusowego, które pozwala określić, jak „blisko” siebie znajdują się dwa wektory w przestrzeni.
Na tej podstawie system sortuje dokumenty według stopnia dopasowania znaczeniowego i zwraca użytkownikowi te, które mają największą semantyczną zgodność z pytaniem. Dzięki temu wyszukiwarka oparta na embeddingach działa nie tylko jak filtr słów kluczowych, ale jak narzędzie rozumiejące intencję użytkownika.
Embedding-Based Retrieval znajduje zastosowanie w wielu dziedzinach, w których liczy się szybki dostęp do właściwych informacji:
Rozwój embeddingów nie byłby możliwy bez odpowiedniego zaplecza technologicznego. Do generowania wektorowych reprezentacji wykorzystuje się modele językowe i uczenia maszynowego, takie jak BERT, Sentence Transformers czy nowoczesne modele dostarczane przez OpenAI. Kluczową rolę odgrywają też bazy danych wektorowych (m.in. Pinecone, Weaviate, Milvus, Vespa), które umożliwiają szybkie przechowywanie i przeszukiwanie milionów embeddingów. W praktyce często łączy się je z narzędziami typu LangChain czy LlamaIndex, które pomagają budować aplikacje integrujące wyszukiwanie semantyczne z innymi funkcjami sztucznej inteligencji. Dzięki tym rozwiązaniom firmy mogą tworzyć chatboty, systemy rekomendacji czy wyszukiwarki dokumentów, które działają nie tylko szybko, ale i w sposób naprawdę inteligentny.
FAQ
Blog
Transfer zrewolucjonizowało uczenie maszynowe, otwierając nowe możliwości. Technika ta polega na wykorzystaniu wiedzy zdobytej podczas rozwiązania jednego problemu do rozwiązania innego, ale powiązanego problemu. Jest niezwykle skuteczna, szczególnie gdy dostępne dane do nauki są ograniczone.
Sztuczna inteligencja w sklepie internetowym ma sens wtedy, gdy rozwiązuje konkretny problem: klienci nie znajdują produktów, opisy są puste, obsługa tonie w tych samych pytaniach. Pokazujemy, od którego objawu zacząć, czego wymaga każde rozwiązanie i jak sprawdzić, czy działa.
Sztuczna inteligencja w obsłudze klienta przeszła drogę od botów z przyciskami do agentów AI, które same załatwiają sprawy w systemach firmy. Pokazujemy na jednym pytaniu klienta, jak odpowiadają cztery generacje botów, kiedy potrzebny jest człowiek, jak mierzyć efekty i od czego zacząć wdrożenie.
Sztuczna inteligencja w hotelarstwie to dziś zestaw konkretnych narzędzi na każdym etapie podróży gościa, od pytań przed rezerwacją po opinie po wyjeździe. Dzielimy je na trzy grupy: to, co już się zwraca, to, co wymaga przygotowania, i to, co na razie jest głównie obietnicą.
AI w treningu personalnym potrafi z kamery telefonu ocenić technikę przysiadu czy martwego ciągu i podpowiedzieć korektę w trakcie serii. Przechodzimy przez jedno powtórzenie krok po kroku: od obrazu, przez szkielet ciała i kąty w stawach, po komunikat dla ćwiczącego, i pokazujemy, gdzie technologia ma granice.
Historia płatności, terminy umów i zgłoszenia najemców mówią o ryzyku więcej, niż się wydaje. Pokazujemy, jak predykcja w nieruchomościach pomaga wcześniej zauważyć zaległości, nieprzedłużone umowy i pustostany, jakich danych potrzebuje model i jak zamienić jego wynik w decyzje zarządcy.