
DataOps, fundament nowoczesnej analityki
Organizacje potrzebują sposobu, by szybciej, pewniej i bardziej elastycznie zamieniać dane w realną wartość. DataOps odpowiada na to wyzwanie, łącząc zasady DevOps, Agile i zarządzania danymi w spójną metodologię usprawniającą cały cykl życia danych. To nie tylko zestaw narzędzi, ale przede wszystkim kultura współpracy, automatyzacji i zaufania do danych – fundament nowoczesnej analityki.

CEO
11 paź 2025
Przez wiele lat organizacje opierały się na klasycznych procesach przetwarzania danych - długich cyklach ETL, ręcznych integracjach i sztywnych hurtowniach danych. Takie podejście działało w czasach, gdy dane były przewidywalne, a raporty generowano raz w tygodniu. Dziś jednak świat biznesu zmienia się w tempie, w którym stare modele nie nadążają. Dane napływają z dziesiątek źródeł - systemów CRM, IoT, aplikacji mobilnych czy mediów społecznościowych - a użytkownicy oczekują analiz w czasie rzeczywistym. Tradycyjne procesy danych często zawodzą: są zbyt powolne, mało elastyczne i podatne na błędy. W efekcie zespoły analityczne tracą czas na gaszenie pożarów zamiast generować wartość z danych. To właśnie w tym miejscu pojawia się potrzeba nowego podejścia - DataOps.
Powiązane case studies

Redesign w Webflow z CMS - strona, którą zespół obsługuje samodzielnie
Klient: HR Hints
Branża: HR / HRTech
Czym właściwie jest DataOps?
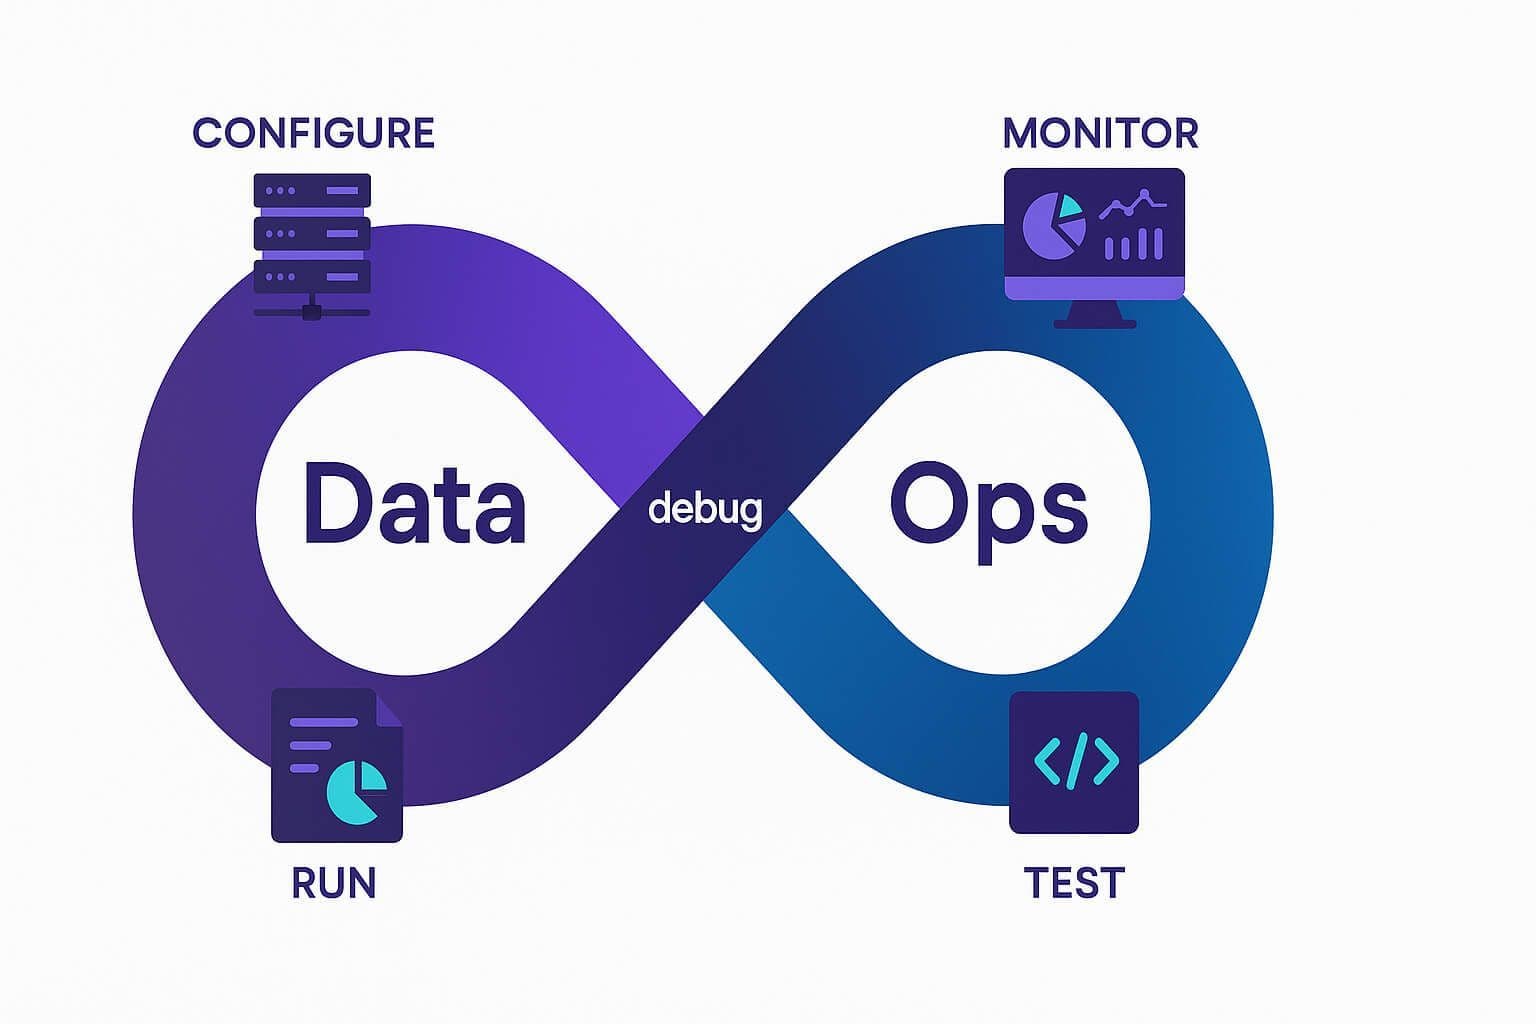
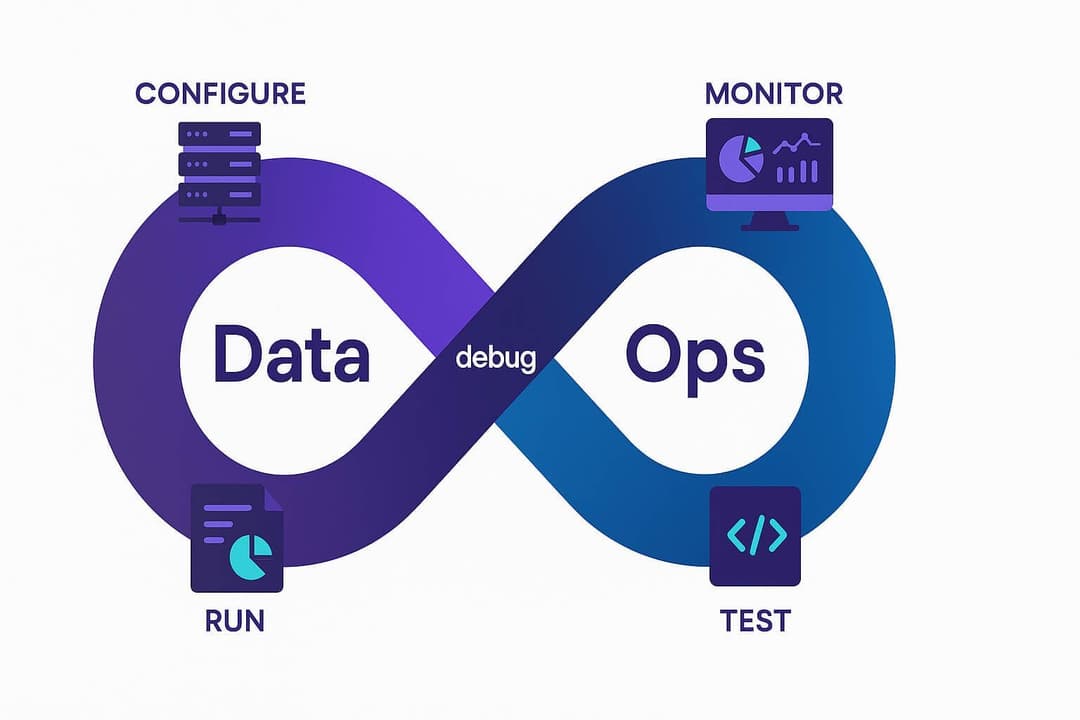
DataOps to nowoczesna metodologia zarządzania danymi, która łączy najlepsze praktyki DevOps, Agile i Lean z obszarem analityki danych. Jej celem jest usprawnienie całego cyklu życia danych - od pozyskania i transformacji, po udostępnienie wyników analitycznych - poprzez automatyzację, testowanie, monitorowanie i współpracę między zespołami. DataOps zakłada, że dane to produkt, który musi być dostarczany szybko, niezawodnie i w wysokiej jakości. Kluczowe są tu zasady ciągłego doskonalenia procesów, wersjonowania kodu analitycznego, automatycznych testów jakości danych oraz ścisłej współpracy między inżynierami danych, analitykami i biznesem. W efekcie DataOps pozwala skrócić czas od pomysłu do działania, zwiększając zaufanie do danych i umożliwiając organizacjom podejmowanie decyzji w oparciu o wiarygodne informacje.
Powiązane usługi


Filary DataOps: ludzie, procesy i technologia
Ludzie są sercem DataOps. To od nich zależy, czy podejście zadziała, bo żadne narzędzie nie zastąpi współpracy między zespołami IT, inżynierii danych, analityki i biznesu. DataOps zakłada kulturę otwartej komunikacji, wspólnej odpowiedzialności i transparentności. Zespoły przestają działać w silosach – inżynier danych, analityk i właściciel produktu pracują razem nad jednym celem: szybkim i wiarygodnym dostarczaniem danych. Dzięki temu zmniejsza się liczba błędów, a proces decyzyjny staje się bardziej zwinny.
Procesy w DataOps mają zapewniać ciągłość i powtarzalność działań. Kluczowe jest tu myślenie procesowe – każde przekształcenie danych, każda walidacja czy publikacja raportu jest częścią większego przepływu, który można testować, monitorować i doskonalić. Procesy DataOps są iteracyjne i oparte na zasadzie ciągłego doskonalenia (Continuous Improvement). Dzięki temu zespoły mogą wprowadzać zmiany w danych lub modelach analitycznych w sposób kontrolowany i przewidywalny, bez ryzyka destabilizacji całego środowiska.
Technologia jest trzecim filarem, który umożliwia realizację założeń DataOps. Narzędzia do orkiestracji przepływów danych (np. Apache Airflow, Dagster), automatyzacji transformacji (np. dbt), testowania jakości (np. Great Expectations) czy monitorowania (np. Prometheus, Grafana) tworzą spójny ekosystem. To właśnie technologia pozwala wdrożyć wersjonowanie kodu danych, automatyczne testy i integrację z pipeline’ami CI/CD, które są fundamentem nowoczesnych środowisk danych.
Powiązane produkty
Automatyzacja i CI/CD w świecie danych
Automatyzacja to jedno z najważniejszych narzędzi, jakie DataOps wnosi do zarządzania danymi. W tradycyjnych procesach wiele kroków – od ekstrakcji danych po ich walidację – było wykonywanych ręcznie, co zwiększało ryzyko błędów i opóźnień. DataOps wprowadza automatyzację na każdym etapie: dane są pobierane, przekształcane, testowane i publikowane w sposób powtarzalny i kontrolowany. Dzięki temu inżynierowie danych mogą skupić się na optymalizacji i jakości, a nie na utrzymaniu codziennych zadań.
Ważnym elementem automatyzacji jest integracja z praktykami CI/CD (Continuous Integration / Continuous Deployment), znanymi z DevOps. W świecie danych oznacza to, że każda zmiana w kodzie transformacji, modelu analitycznym czy pipeline’ie danych jest automatycznie testowana i wdrażana do środowiska produkcyjnego po przejściu walidacji. Pozwala to szybciej reagować na zmiany w źródłach danych i skraca czas dostarczania analiz. CI/CD w DataOps to gwarancja stabilności, kontroli wersji i pełnej przejrzystości – fundament zaufania do danych i procesów analitycznych.
Powiązane branże

Jakość danych i zaufanie jako kluczowe wartości
W DataOps jakość danych nie jest jednorazowym zadaniem – to proces ciągły, zakorzeniony w codziennym działaniu zespołów. Dane stanowią podstawę decyzji biznesowych, dlatego muszą być wiarygodne, spójne i aktualne. Jeśli użytkownicy przestają ufać raportom lub modelom analitycznym, nawet najlepsze narzędzia tracą wartość. DataOps wprowadza systemowe podejście do jakości danych poprzez automatyczne testy, walidacje i monitorowanie anomalii. Każdy etap przetwarzania – od ekstrakcji po publikację – może być objęty kontrolą jakości, dzięki czemu błędy są wykrywane natychmiast, a nie po tygodniach analiz. Budowanie zaufania do danych to również kwestia przejrzystości. W środowisku DataOps wszystkie procesy są wersjonowane, a zmiany w pipeline’ach czy modelach można łatwo prześledzić. Użytkownicy wiedzą, skąd pochodzą dane, jak zostały przekształcone i kiedy były ostatnio aktualizowane. Taka transparentność wzmacnia kulturę odpowiedzialności i pozwala organizacjom traktować dane jako strategiczny zasób, a nie techniczny produkt uboczny. W efekcie DataOps nie tylko poprawia jakość danych, ale buduje zaufanie – zarówno między zespołami technicznymi, jak i między biznesem a danymi.
FAQ
FAQ – DataOps
DataOps to metodyka przenosząca praktyki DevOps, Agile i Lean do świata analityki danych: potoki danych traktuje się jak oprogramowanie — z kontrolą wersji, automatycznymi testami i CI/CD. Składniki: automatyzacja potoków, Git dla kodu danych, testy jakości i schematów, obserwowalność danych, współpraca inżynierów z analitykami i data scientistami oraz ciągłe wdrażanie zmian. To jeden z głównych trendów inżynierii danych ostatnich lat — polskie zespoły w bankach, telekomach i firmach produktowych systematycznie go adoptują.
To ta sama filozofia zastosowana do różnych artefaktów. DevOps spina rozwój i utrzymanie oprogramowania — CI/CD dla aplikacji. DataOps przenosi te praktyki na potoki danych: wersjonowanie transformacji, testy jakości, automatyczne wdrożenia. MLOps robi to samo dla modeli uczenia maszynowego: trenowanie, wdrażanie, monitoring dryfu. W polskich organizacjach DevOps jest dojrzały, DataOps w fazie wzrostu, a MLOps dopiero raczkuje poza najbardziej zaawansowanymi zespołami — co czyni z tych kompetencji naturalną ścieżkę rozwoju seniorskiego inżyniera danych.
Kanon:
- kontrola wersji — Git dla SQL-a, transformacji dbt i konfiguracji potoków,
- CI/CD — automatyczne testy i wdrożenia potoków (GitHub Actions, GitLab CI),
- testy — jakości danych (testy dbt, Great Expectations), schematów, logiki biznesowej,
- monitoring — obserwowalność danych i dashboardy orkiestratora,
- dokumentacja generowana automatycznie (dbt docs) plus katalogi danych,
- współpraca — code review i wspólne standardy inżynierów, analityków i data scientistów,
- reprodukowalność — te same dane i kod dają te same wyniki.
Standardowy zestaw:
- orkiestracja — Apache Airflow (najpopularniejszy), nowocześniejsze Prefect i Dagster,
- transformacje — dbt, dominujące narzędzie nowoczesnej inżynierii danych,
- testy — wbudowane testy dbt, Great Expectations, Soda,
- obserwowalność — Monte Carlo, Bigeye, Datadog,
- dokumentacja — dbt docs i katalogi danych (Atlan, Collibra),
- kontrola wersji — Git (GitHub, GitLab, w korporacjach bywa Bitbucket).
W polskich rekrutacjach mid/senior zestaw dbt plus Airflow plus Git jest już domyślnym oczekiwaniem.
Wymierne efekty:
- szybsze dostarczanie — zmiany w danych wdrażane w minuty i godziny zamiast tygodni,
- wyższa jakość — automatyczne testy wyłapują problemy przed użytkownikami,
- mniej gaszenia pożarów — monitoring wykrywa anomalie wcześnie,
- lepsza współpraca — wspólne standardy zamiast silosów,
- reprodukowalność i ślad audytowy — łatwiejsza zgodność z RODO i regulacjami,
- zachowanie wiedzy — wersjonowany kod i dokumentacja zamiast wiedzy plemiennej.
Rozsądna droga adopcji: najpierw dbt, potem orkiestracja i testy — każdy etap zwraca się osobno, a całość wyraźnie podnosi produktywność zespołu.
Blog
Powiązane artykuły
business intelligence
CPQ – narzędzie do konfiguracji, wyceny i sprzedaży złożonych produktów
Współczesne firmy coraz częściej oferują produkty i usługi o dużej złożoności, które wymagają indywidualnego podejścia do konfiguracji i wyceny. Tradycyjne metody przygotowywania ofert – oparte na arkuszach kalkulacyjnych i ręcznych obliczeniach – stają się nieefektywne, podatne na błędy i czasochłonne. W odpowiedzi na te wyzwania powstały systemy CPQ (Configure, Price, Quote), które automatyzują proces tworzenia ofert handlowych i usprawniają pracę zespołów sprzedaży. Dzięki nim…
Tomasz Kozon
28 paź 2025
AI
Sztuczna inteligencja w hotelarstwie - od rezerwacji po obsługę po pobycie
Sztuczna inteligencja w hotelarstwie to dziś zestaw konkretnych narzędzi na każdym etapie podróży gościa, od pytań przed rezerwacją po opinie po wyjeździe. Dzielimy je na trzy grupy: to, co już się zwraca, to, co wymaga przygotowania, i to, co na razie jest głównie obietnicą.
Tomasz Kozon
05 paź 2026
AI
Predykcja w nieruchomościach - jak dane o najmie pomagają prognozować ryzyko
Historia płatności, terminy umów i zgłoszenia najemców mówią o ryzyku więcej, niż się wydaje. Pokazujemy, jak predykcja w nieruchomościach pomaga wcześniej zauważyć zaległości, nieprzedłużone umowy i pustostany, jakich danych potrzebuje model i jak zamienić jego wynik w decyzje zarządcy.
Tomasz Kozon
01 paź 2026
business intelligence
Cloud kitchens - czym są i jak technologia zmienia branżę gastronomiczną
Cloud kitchens to kuchnie bez sali, które sprzedają wyłącznie przez dostawy. Wyjaśniamy, jakie modele kryją się pod tą nazwą, gdzie kuchnia dostawcza traci marżę i jakie oprogramowanie pozwala jej działać bez rzędu tabletów i ręcznie przepisywanych zamówień.
Tomasz Kozon
28 wrz 2026
business intelligence
Konfigurator ubrań made-to-measure w e-commerce - jak go zaprojektować i wdrożyć?
Klient podaje wymiary, wybiera tkaninę i kołnierzyk - a krawiec szyje tylko dla niego. Konfigurator ubrań made-to-measure zmienia model operacyjny firmy, nie tylko kanał sprzedaży. Sprawdź, jak go zaprojektować, jaką architekturę wybrać i kiedy inwestycja ma sens.
Tomasz Kozon
18 wrz 2026
business intelligence
Self-service w B2B e-commerce - dlaczego klienci biznesowi tego oczekują?
Klient hurtowy chce sam sprawdzić swoją cenę, status dostawy i fakturę, zamiast czekać na oddzwonienie handlowca. Wyjaśniamy, czego klienci biznesowi oczekują od samoobsługi, co musi działać pod spodem i kiedy taki portal się nie opłaci.
Tomasz Kozon
07 wrz 2026