

Czym jest coupling w programowaniu?
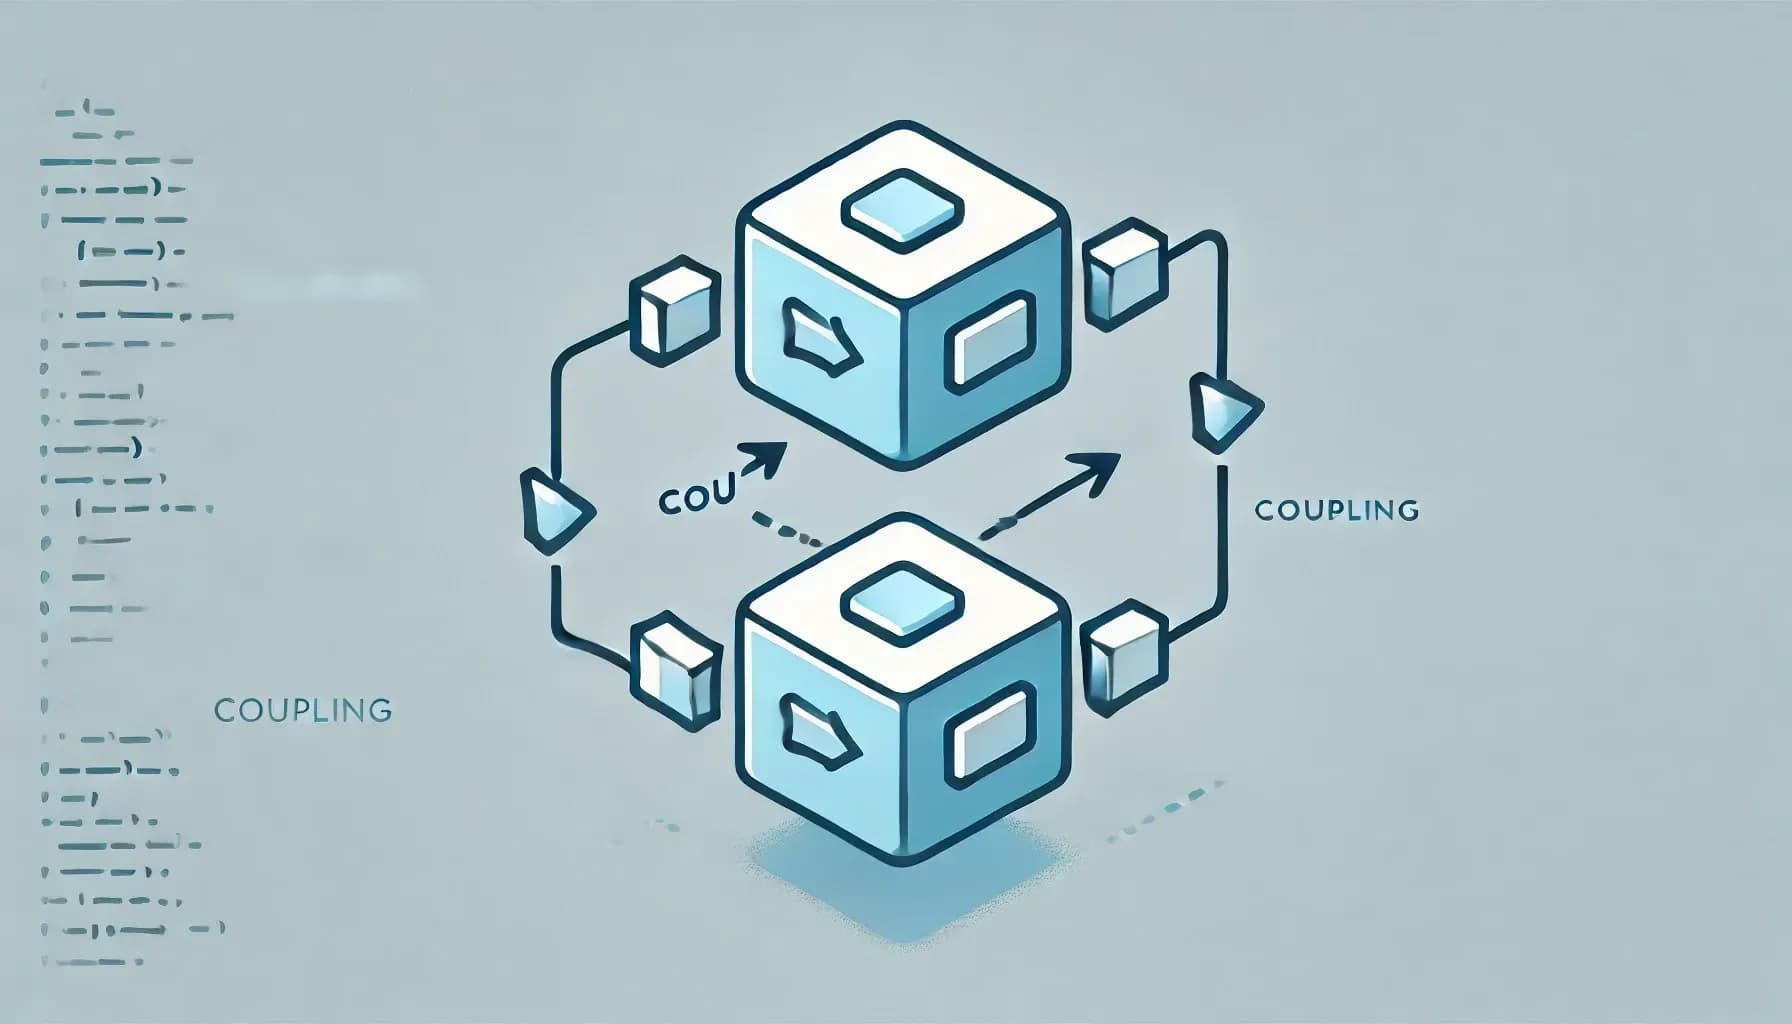
Coupling, czyli sprzężenie, to kluczowe pojęcie w programowaniu, które opisuje stopień zależności między różnymi modułami systemu. Wysoki coupling oznacza silne powiązania, co może utrudniać utrzymanie i rozwój kodu, podczas gdy niski coupling sprzyja elastyczności i łatwiejszemu wprowadzaniu zmian.

CEO
25 lis 2024
Sprzężenie (coupling) w programowaniu to koncepcja odnosząca się do stopnia, do którego jedna jednostka, taka jak klasa lub metoda, jest zależna od innej. Sprzężenie jest zwykle pojmowane jako wartość, której programiści powinni dążyć do zminimalizowania, gdyż wysoki poziom sprzężenia może utrudnić testowanie, utrzymanie i modyfikację kodu. Możemy wyróżnić dwie główne formy sprzężenia: luźne (loose) i mocne (tight). Luźne sprzężenie oznacza, że jednostki są względnie niezależne, a zmiana w jednym nie spowoduje znaczącej modyfikacji w drugim. W przypadku mocnego sprzężenia, zmiana w jednej jednostce zwykle pociąga za sobą konieczność zmian w innych. Zrozumienie i właściwe stosowanie pojęcia sprzężenia jest kluczowe dla efektywnego projektowania i tworzenia oprogramowania.
Powiązane case studies

Marketplace premium kosmetyków na 9 rynkach europejskich - Shopify Plus
Klient: Baza Cosmetics

Platforma edukacyjna generująca materiały do nauki programowania z ChatGPT
Klient: Klient (Aplikacja webowa do nauki programowania)
Branża: Edukacja / EdTech
Przykłady sprzężenia i decoupling w kodzie
Sprzężenie (coupling) w programowaniu dotyczy relacji między różnymi modułami kodu, gdzie jeden moduł zależy od innego. Przykładowo, jeśli mamy dwie klasy A i B, a klasa A korzysta z metody z klasy B, mówimy o sprzężeniu między tymi klasami. Decoupling to proces zmniejszania zależności między modułami. Przyjmując wcześniejszy przykład, jeżeli zdecydujemy, że klasa A nie powinna bezpośrednio korzystać z metody klasy B, ale powinna korzystać z niej przez interfejs, stworzylibyśmy warstwę abstrakcji redukującą sprzężenie. Ten rodzaj projektowania z niskim sprzężeniem sprzyja udoskonaleniu struktury kodu, ułatwiając testowanie i modyfikację.
Powiązane usługi


Rodzaje Coupling: Od luźnego do ścisłego
Coupling, może przybierać różne formy, które klasyfikuje się w zależności od stopnia powiązania między modułami. Na jednym krańcu spektrum znajduje się luźne sprzężenie (loose coupling), gdzie komponenty są minimalnie zależne od siebie. Taki układ sprzyja łatwości modyfikacji, testowania i skalowania aplikacji, ponieważ zmiany w jednym module mają niewielki wpływ na inne. Na przeciwnym biegunie znajduje się ścisłe sprzężenie (tight coupling), gdzie moduły są silnie powiązane, co utrudnia ich modyfikację i zwiększa ryzyko błędów przy zmianach w kodzie. Istnieje także kilka pośrednich rodzajów sprzężenia, takich jak dane wspólne (common coupling), gdzie moduły dzielą globalne zmienne, lub sprzężenie na poziomie treści (content coupling), gdy jeden moduł bezpośrednio zmienia zawartość drugiego. Zrozumienie tych typów jest kluczowe do projektowania systemów o wysokiej jakości i długowieczności, ponieważ właściwe zarządzanie couplingiem pozwala na tworzenie bardziej niezawodnego i elastycznego oprogramowania.]
Jak zidentyfikować ścisłe sprzężenie w swoim kodzie?
Zidentyfikowanie ścisłego sprzężenia w kodzie wymaga uważnej analizy relacji między różnymi komponentami systemu. Jednym z najprostszych sygnałów jest nadmierne poleganie jednego modułu na szczegółach implementacji innego. Na przykład, jeśli zmiana w jednej klasie wymaga modyfikacji wielu innych klas, może to świadczyć o ścisłym sprzężeniu. Inny wskaźnik to częste używanie statycznych zależności, takich jak twardo zakodowane zależności między modułami lub brak elastyczności w zamianie jednej implementacji na inną (np. brak wzorców projektowych takich jak Dependency Injection). Warto również zwrócić uwagę na kod, w którym brakuje jasnego podziału odpowiedzialności — gdy jeden moduł przejmuje zadania, które powinny należeć do innego. Analizując kod, dobrze jest skorzystać z narzędzi takich jak analizy statyczne kodu, które mogą wykrywać skomplikowane zależności między modułami, oraz refaktoryzować fragmenty wykazujące niską modułowość.
Jak zarządzać sprzężeniem dla wydajniejszego kodu?
Zarządzanie sprzężeniem w kodzie można osiągnąć poprzez wprowadzenie kilku kluczowych praktyk. Po pierwsze, należy dążyć do niskiego sprzężenia, tworząc moduły o niezależnych funkcjach. To z kolei zwiększa testowalność, ponieważ każdy moduł może być testowany osobno. Po drugie, stosowanie zasad SOLID może przyczynić się do redukcji sprzężenia, zwłaszcza zasady pojedynczej odpowiedzialności i podstawienia Liskov, które promują niskie sprzężenie i wysoką kohezję. Ponadto, wzorce projektowe, takie jak iniekcja zależności, mogą pomóc w zarządzaniu sprzężeniem poprzez rozdzielenie zależności i kontrolowanie ich implementacji. Końcowo, zrozumienie i właściwe zastosowanie tych praktyk w codziennym programowaniu może przyczynić się do tworzenia kodu wydajniejszego, łatwiejszego w utrzymaniu i bardziej skalowalnego.
FAQ
FAQ – Coupling w programowaniu
Coupling (sprzężenie) to stopień współzależności między modułami, klasami i komponentami oprogramowania. Celem jest sprzężenie luźne: moduły niezależne, w których zmiana jednego nie rozlewa się na resztę; sprzężenie ciasne — gdy każda zmiana kaskadowo psuje kolejne moduły — to klasyczny antywzorzec. Razem ze spójnością (cohesion) tworzy fundamentalną mantrę projektowania: „luźne sprzężenie, wysoka spójność". Niskie sprzężenie umożliwia testowanie, równoległą pracę zespołów, refaktoryzację i skalowanie — wysokie zamienia bazę kodu w kostkę domina.
Skala od najgorszego do najlepszego:
- sprzężenie treścią — moduł sięga do wnętrzności innego; we współczesnym kodzie praktycznie niedopuszczalne,
- sprzężenie wspólne — wiele modułów dzieli stan globalny; zmienne globalne to jego sztandarowy przykład,
- sprzężenie sterowania — moduł steruje przepływem innego przez przekazywane flagi,
- sprzężenie stemplowe — przekazywanie całych struktur, gdy potrzebne jest jedno pole,
- sprzężenie danych — wymiana prostych parametrów; najbardziej akceptowalna forma,
- sprzężenie komunikatami — komunikacja przez dobrze zdefiniowane interfejsy i zdarzenia; wzorzec, do którego dąży nowoczesne projektowanie.
Drogi do luźnego sprzężenia:
- wstrzykiwanie zależności zamiast tworzenia ich na sztywno w klasie,
- programowanie pod interfejsy, nie klasy konkretne (odwrócenie zależności),
- hermetyzacja — ukryty stan wewnętrzny i minimalne API,
- architektura zdarzeniowa: moduły publikują zdarzenia, inne subskrybują, nikt nie zna nikogo,
- mikroserwisy z własnymi bazami — skrajna redukcja sprzężeń między domenami,
- konteksty ograniczone z Domain-Driven Design,
- pojedyncza odpowiedzialność — mniej zadań to mniej zależności.
W dojrzałych zespołach te zasady egzekwuje się w przeglądach kodu.
Na przykładzie: klasa OrderService tworząca wewnątrz new MySQLOrderRepository() jest ciasno sprzężona — przejście na PostgreSQL wymaga zmiany serwisu. Ta sama klasa przyjmująca repozytorium przez konstruktor jest sprzężona luźno — implementacje podmienia się bez dotykania logiki. Podobnie funkcja o siedmiu parametrach kontra funkcja przyjmująca jeden obiekt domenowy hermetyzujący dane. Luźne sprzężenie w praktyce to także nasłuchiwacze zdarzeń (subskrybent nie zna nadawcy) i API REST między usługami. Polskie systemy korporacyjne — zwłaszcza bankowe monolity — historycznie były sprzężone ciasno i właśnie dlatego ich modernizacja trwa latami.
Herezja, którą warto znać: ciaśniejsze sprzężenie bywa w porządku. W małych aplikacjach i prototypach aparat interfejsów i kontenerów DI to nadinżynieria bez zysku; w kodzie krytycznym wydajnościowo warstwy abstrakcji kosztują; wewnątrz jednego spójnego komponentu ciasne powiązania są naturalne (Order i OrderItem mogą się znać) — granice luźności stawia się między komponentami i domenami. Zdrowa postawa: umieć rozpoznawać problemy sprzężeń i refaktoryzować, gdy zaczynają boleć — zamiast dogmatycznie rozprzęgać wszystko na zapas.
Blog
Powiązane artykuły

Back-end
GraalVM: Rewolucja w świecie wirtualnych maszyn
GraalVM wprowadza przełom w świecie wirtualnych maszyn, oferując wyjątkową uniwersalność i wydajność. Zaprojektowany z myślą o współczesnych wymaganiach programistycznych, umożliwia uruchamianie kodu napisanego w wielu językach, w tym Java, JavaScript, Python, i innych, na jednej platformie.
Tomasz Kozon
06 lut 2024

Back-end
Czym jest SOAP i jak działa?
SOAP to protokół służący do wymiany informacji między różnymi systemami. Dzięki niemu możliwe jest przesłanie kompleksowych danych w formacie XML za pomocą sieci. W artykule dowiesz się, jak działa SOAP i jakie ma zastosowania.
Tomasz Kozon
10 maj 2023
Back-end
Turso - nowoczesna baza danych oparta na SQLite. Co warto o niej wiedzieć?
Turso to baza danych oparta na SQLite, która pozwala dać każdemu klientowi osobną bazę, pracować offline z późniejszą synchronizacją i wyszukiwać dane po znaczeniu. Na przykładzie jednej aplikacji pokazujemy, co Turso daje na kolejnych etapach rozwoju produktu i kiedy lepiej wybrać coś innego.
Tomasz Kozon
06 wrz 2026
Big Data
DuckDB - dlaczego analityczna baza danych działa bez serwera
DuckDB to analityczna baza danych, która działa wewnątrz aplikacji, bez serwera i bez administratora. Wyjaśniamy, skąd bierze się jej szybkość, jak czyta pliki CSV i Parquet bez importu, gdzie sprawdza się w firmie, czego nie zastąpi i co zmienia zapowiadany tryb serwera w wersji 2.0.
Tomasz Kozon
23 sie 2026
Back-end
Bruno - open source’owa alternatywa dla Postmana. Kiedy zmiana narzędzia ma sens?
Od marca 2026 r. darmowy Postman obsługuje tylko jednego użytkownika, a kolekcje zapytań do API wciąż są głównie w chmurze dostawcy. Wyjaśniamy, czym jest Bruno, ile kosztuje przejście i w jakich zespołach nie ma ono sensu.
Tomasz Kozon
05 sie 2026
Back-end
ElectricSQL - synchronizacja danych w czasie rzeczywistym. Jak działa i do czego służy?
ElectricSQL przesyła zmiany z bazy PostgreSQL prosto na ekrany użytkowników, bez ręcznego odświeżania i bez budowania własnej warstwy powiadomień. Tłumaczymy, jak działa ten silnik synchronizacji, jakie ma ograniczenia i w jakich projektach lepiej wybrać coś prostszego.
Tomasz Kozon
25 lip 2026