

Mastra AI: jak budować agentów AI w TypeScript
Mastra AI to otwartoźródłowy framework do budowy agentów AI w TypeScript. Zamiast opisywać go funkcja po funkcji, składamy z niego jednego agenta dla fikcyjnego sklepu rowerowego, wersja po wersji - od instrukcji, przez narzędzia, pamięć i RAG, po akceptację człowieka, testy i wdrożenie.

CEO
11 sie 2026
Mastra AI to otwartoźródłowy framework do budowy agentów AI w TypeScript, czyli w tym samym języku, w którym powstaje dziś duża część aplikacji webowych. Agent AI to program, w którym model językowy sam decyduje, jakie kroki wykonać i z jakich narzędzi skorzystać, żeby załatwić sprawę klienta albo pracownika. Mastra daje do tego gotowe klocki: narzędzia, pamięć, przepływy pracy, testy jakości i podgląd tego, co agent właściwie robi. Za projektem stoją twórcy Gatsby'ego, popularnego frameworka do budowy stron. Wersja 1.0 ukazała się 20 stycznia 2026 roku z zapowiedzią, że interfejs programistyczny jest już ustabilizowany. W tym samym ogłoszeniu autorzy podali ponad 300 tys. pobrań tygodniowo z rejestru npm i wymienili wśród firm używających Mastry produkcyjnie m.in. Replit, PayPal i Sanity.
Mastra AI w skrócie: framework do agentów w TypeScript
Mastra jest biblioteką, którą programista instaluje w projekcie Node.js, czyli w środowisku uruchamiającym kod JavaScript i TypeScript na serwerze. Nie jest gotowym chatbotem ani platformą do wyklikania. To zestaw elementów, z których zespół składa własne rozwiązanie, a kod i dane zostają u firmy. Z modelami językowymi Mastra łączy się przez wspólny interfejs. Model wskazuje się jednym napisem w formacie „dostawca/model", więc przejście z modelu OpenAI na Claude od Anthropic to zwykle zmiana jednej linijki i klucza dostępu. Zwykle, bo modele różnią się zachowaniem i po każdej zmianie agenta trzeba przetestować od nowa. Tak samo wygląda przejście na Gemini od Google. Licencja jest prosta, z jednym wyjątkiem. Rdzeń frameworka udostępniono na licencji Apache 2.0, która pozwala używać go komercyjnie bez opłat. Część funkcji dla dużych firm leży w osobnych katalogach na licencji Mastra Enterprise License: można je testować, ale do użycia produkcyjnego potrzebna jest płatna licencja.
AI długo kojarzyło się z Pythonem, w którym powstały pierwsze popularne biblioteki do pracy z modelami językowymi. Tymczasem sklepy, panele i systemy, z którymi agent ma współpracować, często działają na JavaScripcie i TypeScripcie, czyli JavaScripcie z kontrolą typów danych. W sierpniu 2025 roku TypeScript po raz pierwszy wyprzedził Pythona pod względem liczby osób rozwijających kod na GitHubie, a GitHub wiąże to m.in. z popularnością narzędzi AI. Agent napisany w tym samym języku co reszta systemu korzysta z tych samych typów danych, testów i ludzi. Nie trzeba utrzymywać osobnej usługi w Pythonie tylko po to, żeby sprawdzić status zamówienia. Te same zalety TypeScriptu, które pomagają w zwykłej aplikacji, chronią też przed błędami w kodzie agenta.
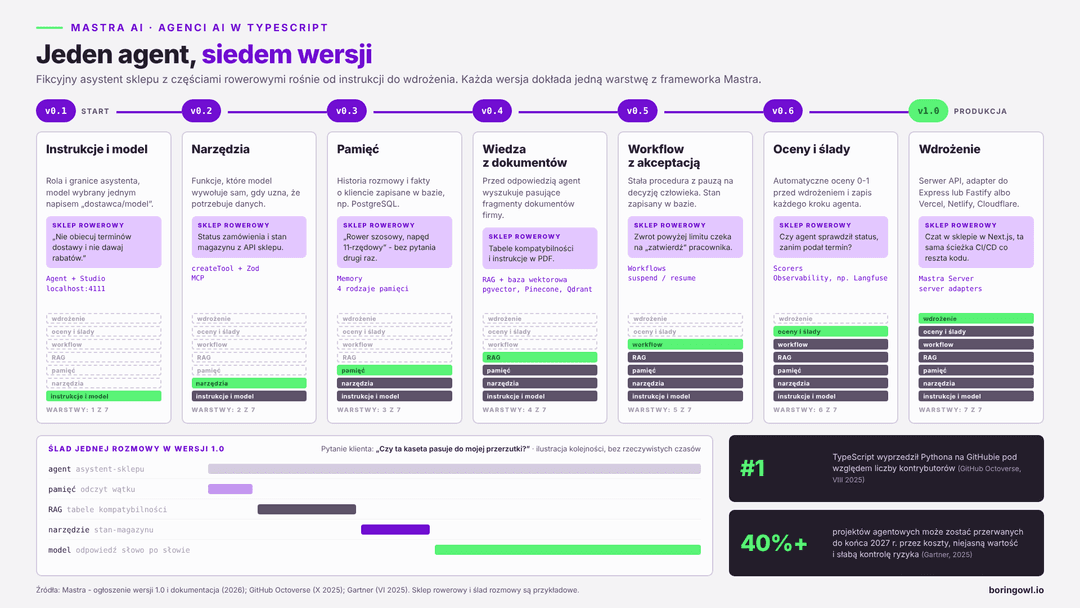
Wersja 0.1: instrukcje, model i pierwsza rozmowa w Studio
Pierwsza wersja asystenta sklepu składa się z nazwy, modelu i instrukcji. Instrukcje to opis roli i granic, który model dostaje przed każdą rozmową. W naszym przykładzie mówią, że asystent odpowiada klientom sklepu z częściami rowerowymi, pisze po polsku, nie obiecuje terminów dostawy i nie przyznaje rabatów. Pisanie takich instrukcji to w dużej mierze prompt engineering, czyli praca nad tym, jak sformułować polecenie, żeby model zachowywał się przewidywalnie.
Taki agent już działa. Mastra Studio, lokalny panel otwierany w przeglądarce pod adresem localhost:4111, pozwala z nim porozmawiać, poprawić instrukcje i od razu zobaczyć efekt. Odpowiedź może pojawiać się słowo po słowie, bo Mastra obsługuje strumieniowanie. Na tym etapie agent jest jednak tylko uprzejmym rozmówcą. Nie wie, co leży w magazynie ani gdzie jest paczka klienta. Zapytany o konkretne zamówienie, może zmyślić odpowiedź, która brzmi wiarygodnie. Druga wersja dostaje więc narzędzia.
Realizacje

Platforma edukacyjna generująca materiały do nauki programowania z ChatGPT
Klient: Klient (Aplikacja webowa do nauki programowania)
Branża: Edukacja / EdTech
Wersja 0.2: narzędzia, czyli dostęp do danych sklepu
Narzędzie to funkcja w kodzie, którą model może wywołać, gdy uzna, że jej potrzebuje. Ma nazwę, opis zrozumiały dla modelu i schemat danych wejściowych. Asystent sklepu dostaje dwa narzędzia: sprawdzenie statusu zamówienia i stanu magazynowego części. Oba łączą się z API sklepu, czyli interfejsem, przez który programy wymieniają dane. W kodzie takie narzędzie to kilkanaście linijek. Programista podaje identyfikator, opis w rodzaju „sprawdza status zamówienia po jego numerze", schemat danych wejściowych i funkcję, która pyta sklep o status. Schemat zapisuje się w bibliotece Zod, która sprawdza dane, zanim narzędzie się uruchomi. Gotowe narzędzie dopisuje się do listy narzędzi agenta i od tej chwili model sam decyduje, kiedy po nie sięgnąć.
Ta decyzja opiera się wyłącznie na opisie. Jeśli opis jest mętny, model wywoła narzędzie nie wtedy, kiedy trzeba, albo wcale. W praktyce przy narzędziach więcej czasu zajmują nazewnictwo i opisy niż samo połączenie z API.
Narzędzia nie zawsze trzeba pisać od zera. Mastra obsługuje MCP, otwarty protokół, przez który agenci korzystają z narzędzi udostępnianych przez inne systemy. Działa to w obie strony: agent może używać cudzych serwerów MCP, a firma może wystawić własnego agenta jako serwer MCP. Dokumentacja zaznacza przy tym, że wyniki narzędzi należy traktować jak niezweryfikowane dane, a nie polecenia.
Wersja 0.3: pamięć rozmowy i klienta
Klient pisze rano, że ma rower szosowy z napędem 11-rzędowym, a po południu pyta o kasetę. Bez pamięci asystent zapyta o rower drugi raz. Mastra ma kilka rodzajów pamięci, które można łączyć:
- historia wiadomości - ostatnie wiadomości z wątku, w wersji 1.0 domyślnie dziesięć,
- pamięć robocza - uporządkowane fakty o kliencie, na przykład model roweru albo preferowana forma dostawy, zachowywane między rozmowami,
- przypominanie semantyczne - wyszukiwanie starszych wiadomości po znaczeniu, a nie po słowach; w wersji 1.0 domyślnie wyłączone,
- pamięć obserwacyjna - agenci działający w tle, którzy streszczają długą historię, żeby nie zapychała kontekstu modelu.
Pamięć trzeba gdzieś zapisać. Mastra obsługuje ponad dwadzieścia baz i usług, w tym PostgreSQL, MongoDB i Redis. Najprościej użyć bazy, którą aplikacja i tak już ma. Każda zapamiętana informacja to dane klienta przechowywane przez firmę. Przy wdrożeniach chatbotów AI ustalamy, które dane mogą trafić do modelu, co maskujemy i jak długo przechowujemy rozmowy. Przy agencie z pamięcią roboczą to pytanie trzeba zadać jeszcze wcześniej, bo agent zapamiętuje fakty sam.
Powiązany produkt
Wersja 0.4: wiedza z dokumentów, czyli RAG
Pytanie „czy ta kaseta pasuje do mojej przerzutki?" wymaga wiedzy, której nie ma w bazie zamówień. Jest w tabelach kompatybilności producentów, instrukcjach w PDF i opisach produktów. Tu przydaje się RAG, czyli technika, w której agent przed odpowiedzią wyszukuje pasujące fragmenty dokumentów i odpowiada na ich podstawie. Mastra dzieli dokumenty na fragmenty, zamienia je na embeddingi, czyli liczbowe reprezentacje znaczenia tekstu, i zapisuje w bazie wektorowej. Przy pytaniu klienta wyszukuje kilka najbardziej podobnych fragmentów i przekazuje je modelowi. Tak działa wyszukiwanie oparte na embeddingach: podobieństwo liczy się dla znaczenia, a nie dla pojedynczych słów.
Bazę wektorową można postawić na tym samym PostgreSQL z rozszerzeniem pgvector albo użyć osobnej usługi, takiej jak Pinecone czy Qdrant. Jakość odpowiedzi zależy tu bardziej od dokumentów niż od frameworka. Nieaktualna tabela kompatybilności da złą odpowiedź niezależnie od modelu. W chatbocie, który przygotowaliśmy dla BlueApart, bazę wiedzy edytuje zespół klienta. Sklep rowerowy też potrzebuje osoby, która odpowiada za aktualność tabel i instrukcji.
RAG wzmacnia to, co jest w dokumentach
Jakość odpowiedzi agenta z RAG zależy bardziej od dokumentów niż od frameworka. Nieaktualna tabela kompatybilności, niekompletna instrukcja albo brak polityki zwrotów da złą odpowiedź niezależnie od wybranego modelu. Przed uruchomieniem ustal, kto w firmie odpowiada za aktualność bazy wiedzy i jak często jest ona aktualizowana.
Wersja 0.5: workflow i akceptacja człowieka przy zwrotach
Zwrot towaru to inny rodzaj zadania niż odpowiedź na pytanie. Kroki są znane: sprawdzić zamówienie i termin na zwrot, przygotować zgłoszenie, wygenerować etykietę. Nie ma sensu, żeby model za każdym razem sam wymyślał tę kolejność. Do takich zadań Mastra ma workflowy, czyli przepływy pracy z ustalonymi z góry krokami. Kroki łączy się w kodzie jak klocki. Jedne wykonują się po kolei, inne równolegle, w rozgałęzieniu workflow wybiera ścieżkę według warunku, a pętla powtarza krok dla każdej pozycji, na przykład dla każdej części w zamówieniu. Krok może wywołać zwykły kod, narzędzie albo agenta. W praktyce agent zbiera od klienta dane w rozmowie, a workflow pilnuje procedury.
Najważniejsza jest możliwość wstrzymania. Workflow może zatrzymać się w połowie, zapisać stan i czekać na decyzję człowieka. W sklepie rowerowym zwrot powyżej ustalonej kwoty trafia do pracownika, który klika „zatwierdź" albo „odrzuć", a workflow rusza dalej od miejsca, w którym stanął. Stan jest zapisany w bazie, więc przerwa może trwać godzinę albo dwa dni, a restart serwera nie gubi zgłoszenia.
To nie jest ostrożność na wyrost. Gartner przewiduje, że do końca 2027 roku ponad 40% projektów opartych na agentach AI zostanie przerwanych, a jako przyczyny wskazuje rosnące koszty, niejasną wartość biznesową i niewystarczającą kontrolę ryzyka. Akceptacja człowieka tam, gdzie agent wydaje pieniądze albo zmienia dane, to najprostsza forma takiej kontroli.
Prompt injection: agent czyta też treść z zewnątrz
Agent z narzędziami może zrobić więcej niż chatbot - dlatego ryzyko prompt injection jest tu poważniejsze. Przemycenie poleceń modelowi przez treść wiadomości klienta, dokumentu albo wynik narzędzia to realne zagrożenie. Przed udostępnieniem agenta klientom warto przeprowadzić audyt bezpieczeństwa i ograniczyć agenta wyłącznie do uprawnień, których naprawdę potrzebuje.
Wersja 0.6: oceny jakości, ślady i koszty
Agenta nie da się przetestować jak formularza, bo na to samo pytanie potrafi odpowiedzieć na dwa sposoby. Mastra ma do tego scorery, czyli automatyczne oceny odpowiedzi w skali od 0 do 1. Część z nich ocenia inny model językowy, na przykład trafność odpowiedzi względem pytania. Inne to proste reguły: czy agent wywołał narzędzie do statusu zamówienia, zanim podał termin dostawy. Oceny mogą działać na żywo, na wybranym odsetku rozmów, albo przed każdym wdrożeniem, jako część testów oprogramowania. W tym wariancie zestaw typowych pytań klientów działa jak test regresji: jeśli po zmianie instrukcji agent zaczyna mylić statusy, zmiana nie trafia do klientów.
Mastra zapisuje każdy przebieg agenta, wywołanie modelu i użycie narzędzia jako ślad z danymi wejściowymi, wynikiem, liczbą tokenów i czasem. Ślady można oglądać w Studio albo wysyłać do zewnętrznych narzędzi, takich jak Langfuse, Datadog czy dowolna platforma zgodna z OpenTelemetry. Tokeny to jednostki tekstu, za które płaci się dostawcy modelu, więc ślady służą też do kontroli kosztów.
Usługi


Wersja 1.0: wdrożenie obok istniejącej aplikacji
Gotowego agenta trzeba gdzieś uruchomić. Mastra może działać jako samodzielny serwer API postawiony na maszynie wirtualnej, w kontenerze Docker albo w chmurze AWS. Od wersji 1.0 Mastrę można też wpiąć w istniejący serwer aplikacji napisany w Express, Fastify, Hono albo Koa. Agent działa wtedy w tym samym procesie co reszta aplikacji i może korzystać z jej mechanizmów, na przykład logowania użytkowników. Są też gotowe paczki wdrożeniowe dla platform Vercel, Netlify i Cloudflare, przydatne, gdy reszta aplikacji już tam działa. Niezależnie od miejsca agent powinien trafiać na produkcję tą samą ścieżką co reszta kodu, przez CI/CD. Zmiana instrukcji to też zmiana w kodzie i przechodzi przez te same oceny.
Agent może też być po prostu kolejnym modułem aplikacji, którą firma już ma. Dla sklepu Kwant zbudowaliśmy frontend w Next.js i TypeScripcie, a panel treści połączony z ChatGPT automatycznie generuje tam wpisy na bloga. W platformie edukacyjnej do nauki programowania zaplecze w Node.js tworzy przez API ChatGPT fiszki i quizy z wybranych tagów. W obu przypadkach model dostaje zadanie i zwraca tekst. Gdyby funkcja miała sama sięgać po dane, pamiętać użytkownika i czekać na akceptację, byłby to dobry moment na framework taki jak Mastra.
Kiedy Mastra, a kiedy inne narzędzie
Mastra nie jest jedyną drogą do agenta. Zespół, który pisze w Pythonie, ma do dyspozycji LangGraph i resztę ekosystemu LangChain. Prostsze automatyzacje da się złożyć w narzędziach wizualnych, takich jak Dify czy n8n. Nie każdy projekt potrzebuje frameworka w kodzie.
Mastra ma sens, gdy:
- zespół i aplikacja już pracują w TypeScripcie, na przykład w Next.js albo Node.js,
- agent ma korzystać z kilku narzędzi i systemów firmy, a nie tylko generować tekst,
- część procesu wymaga stałej procedury albo akceptacji człowieka,
- jakość odpowiedzi trzeba mierzyć i porównywać między wersjami,
- firma chce zachować kod i dane u siebie, bez zamkniętej platformy.
FAQ
FAQ - Najczęściej zadawane pytania o Mastrę AI
- Tak, rdzeń Mastry jest darmowy i udostępniony na otwartej licencji Apache 2.0, która pozwala na użycie komercyjne. Płatna jest tylko część funkcji dla dużych organizacji, objęta licencją Mastra Enterprise License: można z nich korzystać przy tworzeniu i testach, ale w produkcji wymagają wykupienia licencji. Sam framework to jednak nie cały koszt działania agenta. Płaci się dostawcy modelu językowego za przetworzone tokeny, za serwer lub chmurę i za bazę danych. Przykładowo agent obsługujący kilkaset rozmów dziennie generuje koszty modelu zależne od długości rozmów i wybranego modelu. Ostateczny rachunek zależy od ruchu, wybranego modelu i tego, czy potrzebne są funkcje z licencji enterprise.
- Orientacyjnie od kilkudziesięciu tysięcy złotych za prototyp z jednym lub dwoma narzędziami do ponad stu tysięcy złotych za agenta produkcyjnego z integracjami, wyszukiwaniem w dokumentach i akceptacją człowieka. Na koszt składają się analiza procesu, przygotowanie dokumentów, integracje z systemami firmy, testy jakości, zabezpieczenia i wdrożenie. Do tego dochodzą stałe opłaty za model językowy i hosting, które przy typowym ruchu wynoszą od kilkuset do kilku tysięcy złotych miesięcznie. Przykładowo asystent odpowiadający na pytania o status zamówień będzie tańszy niż agent, który przyjmuje zwroty i zmienia dane w systemie ERP. Kwota zależy od liczby integracji, jakości dokumentów, wymagań bezpieczeństwa i skali ruchu.
- Prototyp powstaje zwykle w 2-4 tygodnie, a wersja produkcyjna w 2-4 miesiące, zależnie od liczby integracji i wymagań jakościowych. Prototyp pozwala sprawdzić na prawdziwych pytaniach, czy agent rozumie temat i poprawnie korzysta z narzędzi. Wersja produkcyjna wymaga dodatkowo zestawu testów, monitorowania, zabezpieczeń, procedury przekazania sprawy człowiekowi i szkolenia zespołu. Przykładowo agent odpowiadający na pytania o produkty na podstawie jednej bazy dokumentów może być gotowy szybciej niż agent połączony z CRM, systemem magazynowym i płatnościami. Czas zależy od dostępności API w systemach firmy, przygotowania dokumentów i tempa akceptacji po stronie klienta.
- Tak, Mastra obsługuje modele wielu dostawców, w tym Claude od Anthropic, Gemini od Google i modele OpenAI, przez jeden wspólny interfejs. Model wybiera się napisem w formacie dostawca/nazwa modelu, a do działania potrzebny jest klucz API danego dostawcy. Dzięki temu można porównać kilka modeli na tym samym zestawie pytań i wybrać ten, który daje najlepsze odpowiedzi w rozsądnej cenie. Przykładowo proste pytania może obsługiwać tańszy model, a trudniejsze zadania mocniejszy. Wybór zależy od jakości odpowiedzi w języku polskim, kosztu, szybkości działania i wymagań dotyczących miejsca przetwarzania danych.
- Tak, Mastrę można uruchomić w aplikacji Next.js albo obok niej, a dokumentacja zawiera osobny przewodnik integracji z Next.js na platformie Vercel. W pierwszym wariancie agent działa w tym samym projekcie co strona i korzysta z tych samych typów danych oraz konfiguracji. W drugim działa jako osobny serwer API, z którym aplikacja komunikuje się przez zapytania HTTP. Przykładowo czat w sklepie zbudowanym w Next.js może wysyłać pytania klienta do agenta i wyświetlać odpowiedź słowo po słowie. Wybór wariantu zależy od skali ruchu, sposobu hostingu i tego, czy z agenta mają korzystać także inne aplikacje.
- Tak, agent może odczytywać i zapisywać dane w CRM lub ERP przez narzędzia, czyli funkcje łączące się z API tych systemów, albo przez serwery MCP, jeśli system je udostępnia. Każde narzędzie dostaje ściśle określony zakres, na przykład odczyt statusu zamówienia bez możliwości zmiany ceny. Operacje, które zmieniają dane albo kosztują pieniądze, najlepiej przepuszczać przez akceptację pracownika. Przykład: agent przygotowuje w CRM szkic oferty na podstawie rozmowy, a handlowiec zatwierdza go przed wysłaniem. Zakres prac zależy od tego, czy system ma udokumentowane API, jakie uprawnienia można nadać kontu technicznemu i jak wrażliwe są dane.
- Tak, programista znający TypeScript i Node.js szybko uruchomi w Mastrze pierwszego agenta, bo framework opiera się na znanych mu elementach: funkcjach, schematach danych i serwerze API. Nowe są umiejętności typowe dla projektów z modelami językowymi: pisanie instrukcji, projektowanie opisów narzędzi, przygotowanie dokumentów do wyszukiwania i ocena jakości odpowiedzi. Tych rzeczy nie sprawdzi zwykły test jednostkowy, bo ten sam agent może odpowiedzieć na jedno pytanie na kilka sposobów. Przykładowo podłączenie agenta do API sklepu bywa najprostszą częścią pracy, a najwięcej czasu zajmuje dopracowanie odpowiedzi w nietypowych sytuacjach. Tempo nauki zależy od złożoności procesu i dostępu do osoby z doświadczeniem w projektach LLM.
- Tak, agent zbudowany w Mastrze działa jako usługa z API, więc można go podłączyć do Slacka, Microsoft Teams albo firmowego intranetu przez aplikację-bota danego komunikatora. Bot przekazuje wiadomość pracownika do agenta, a odpowiedź wraca do tego samego wątku. W takim wdrożeniu trzeba zadbać, żeby agent widział tylko dane, do których dostęp ma pytająca osoba, na przykład wyłącznie dokumenty jej działu. Przykład: asystent na kanale działu sprzedaży odpowiada na pytania o cenniki i warunki umów na podstawie aktualnych dokumentów. Zakres prac zależy od komunikatora, sposobu logowania pracowników i liczby systemów, z których agent ma korzystać.
Blog
Powiązane artykuły
AI
Duże modele językowe (LLM): Mechanizm działania i znaczenie dla przełomu w dziedzinie sztucznej inteligencji
W świecie AI, duże modele językowe (LLM) stają się kluczowym elementem ewolucji. Pozwalają maszynom na naturalne 'rozumienie' i generowanie języka ludzkiego. Na czym jednak polega ich działanie? Jak wpłynęły na przełom w sztucznej inteligencji? Sprawdźmy to!
Tomasz Kozon
12 gru 2024
AI
Prompt Engineering: Jak skutecznie komunikować się z modelami AI
Komunikacja z modelami sztucznej inteligencji staje się nieodłączna w nowoczesnym świecie. Efektywna wymiana informacji między człowiekiem a AI to nie tylko zdolność do zrozumienia się nawzajem, ale także osiągnięcie wspólnego celu. Jak optymalizować ten proces? Odkryjmy razem sekrety efektywnej komunikacji z AI.
Tomasz Kozon
11 mar 2024
Back-end
Dlaczego warto korzystać z TypeScript?
TypeScript to rozszerzenie języka JavaScript, które pozwala na tworzenie bardziej zaawansowanych aplikacji webowych. Korzystanie z TypeScript pozwala na lepszą organizację kodu, większą czytelność oraz mniejszą liczbę błędów.
Tomasz Kozon
19 wrz 2022
AI
RAG: Rewolucyjna metoda generowania AI i dlaczego stanowi przyszłość technologii
Sztuczna inteligencja rozwija się w błyskawicznym tempie, a jednym z jej najnowszych i najbardziej obiecujących osiągnięć jest technologia RAG (Retrieval-Augmented Generation). To innowacyjne podejście łączy możliwości generowania tekstu przez AI z dynamicznym wyszukiwaniem informacji w zewnętrznych źródłach. Dzięki temu odpowiedzi są nie tylko poprawne językowo, ale także aktualne i oparte na zweryfikowanych danych.
Tomasz Kozon
12 sie 2025
AI
Embedding-Based Retrieval: Jak działa inteligentne wyszukiwanie danych?
Codziennie korzystamy z wyszukiwarek – czy to w internecie, czy w firmowych bazach wiedzy – oczekując szybkiego i trafnego dostępu do informacji. Tradycyjne metody oparte na słowach kluczowych często zawodzą, bo nie rozumieją kontekstu ani intencji użytkownika. Rozwiązaniem tego problemu stało się Embedding-Based Retrieval, czyli inteligentne wyszukiwanie oparte na wektorowych reprezentacjach danych.
Tomasz Kozon
28 wrz 2025
Project manager
CI/CD - na czym polega i jak prawidłowo stosować tę metodę
CI/CD to skrót od Continuous Integration i Continuous Delivery, czyli procesów ciągłej integracji i ciągłego dostarczania. Jest to metoda zarządzania projektem oprogramowania, która polega na ciągłym i automatycznym sprawdzaniu, testowaniu i wdrażaniu kodu do produkcji.
Tomasz Kozon
14 mar 2022