Firecrawl w praktyce: jak zamienić stronę internetową w dane dla AI
Firecrawl zamienia strony internetowe w czysty markdown i uporządkowany JSON, z którymi modele językowe radzą sobie znacznie lepiej niż z surowym HTML. Pokazujemy, jak działa, jak wykorzystać go do budowy bazy wiedzy chatbota, ekstrakcji danych i agentów AI oraz ile to kosztuje.
Firecrawl to narzędzie, które pobiera stronę internetową i oddaje ją w formie, z którą model AI potrafi pracować: czystego tekstu w formacie markdown albo uporządkowanych danych JSON. W praktyce Firecrawl zdejmuje z zespołu najbardziej żmudną część projektów AI. Brzmi jak drobiazg techniczny. Dopóki nie spróbuje się podać modelowi językowemu surowego kodu strony z menu, stopką, banerem cookies i skryptami analitycznymi. Wtedy okazuje się, że większość pracy przy projektach AI to przygotowanie danych, a nie samo pytanie do modelu. Firmy chcą, żeby chatbot odpowiadał na podstawie treści z ich serwisu, dokumentacji produktu czy bazy wiedzy. Chcą śledzić ceny konkurencji, zbierać oferty z portali branżowych albo dać agentowi AI dostęp do aktualnych informacji z internetu. W każdym z tych przypadków pierwszy krok jest ten sam. Trzeba zamienić strony w dane.
Jako software house wdrażamy rozwiązania AI oparte na firmowych treściach i regularnie sięgamy po narzędzia do pobierania danych z sieci. Poniżej wyjaśniamy, jak działa Firecrawl, gdzie się sprawdza, ile kosztuje i o czym trzeba pamiętać, zanim zbuduje się na nim cokolwiek produkcyjnego.
Dlaczego strona internetowa nie jest od razu gotowa dla AI
Strona, którą widzi człowiek, i strona, którą dostaje program, to dwie różne rzeczy. Przeglądarka pobiera kod HTML, uruchamia skrypty, doczytuje treści w tle i dopiero wtedy pokazuje gotowy widok. W samym HTML właściwy tekst artykułu bywa niewielką częścią całości. Resztę stanowią menu, stopki, formularze, kod śledzący i ukryte elementy. Dla modelu językowego każdy z tych elementów to szum. Model rozlicza się w tokenach, czyli fragmentach tekstu, od których zależy koszt i limit długości zapytania, więc śmieci w danych kosztują podwójnie: płaci się za nie i pogarszają one odpowiedź. Chatbot, który w bazie wiedzy ma dwieście kopii tej samej stopki, zaczyna cytować stopkę.
Klasyczny web scraping, czyli automatyczne pobieranie danych, rozwiązuje ten problem ręcznie. Programista pisze reguły dla konkretnej strony: tu jest tytuł, tu cena, tu treść. Działa to dobrze, dopóki strona się nie zmieni. A zmienia się regularnie.
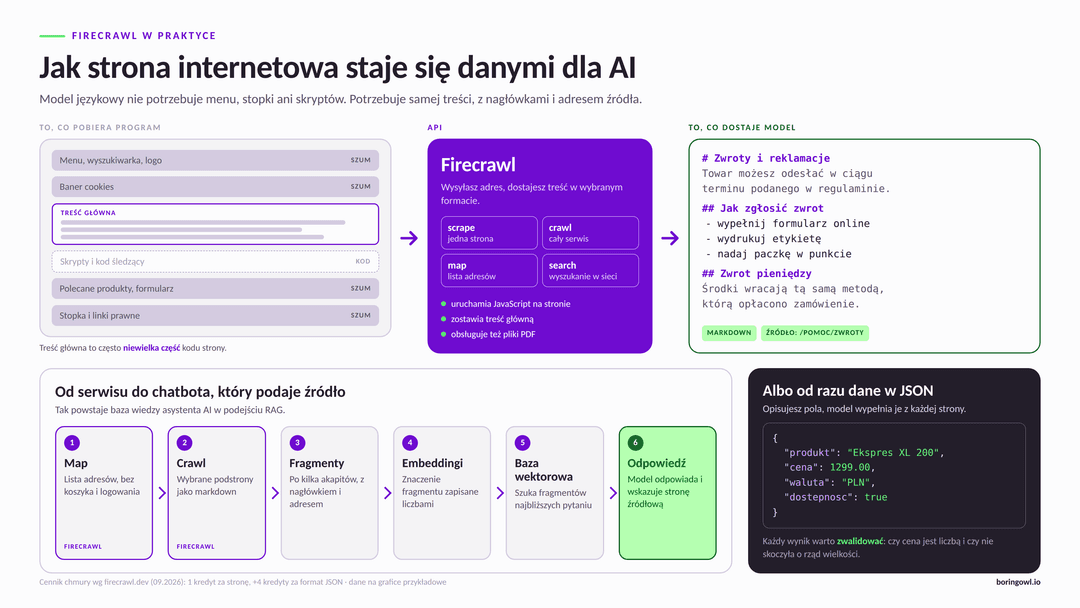
Firecrawl to usługa dostępna przez API, czyli interfejs, przez który jeden program zamawia coś u drugiego. Wysyła się adres strony, a w odpowiedzi przychodzi jej treść w wybranym formacie. Narzędzie samo radzi sobie z uruchamianiem skryptów na stronie, doczytywaniem dynamicznych treści i usuwaniem elementów, które nie należą do głównej zawartości.
Najczęściej używane funkcje to:
scrape - pobranie jednej strony jako markdown, HTML, JSON, zrzut ekranu lub lista linków,
crawl - przejście po całym serwisie lub jego części i pobranie wszystkich podstron,
map - szybkie wylistowanie adresów w serwisie bez pobierania ich treści,
search - wyszukanie informacji w sieci i od razu pobranie treści z wyników,
interact i akcje - kliknięcie, przewinięcie czy wypełnienie pola przed pobraniem treści,
parse - zamiana plików PDF, DOCX czy XLSX na markdown lub JSON.
Dla nas najważniejszy jest format wyjściowy. Markdown, prosty język formatowania tekstu, zachowuje nagłówki, listy i tabele, a pomija całą warstwę techniczną. Model dostaje strukturę dokumentu bez balastu. Firecrawl ma wersję w chmurze i wersję open source do samodzielnego uruchomienia. Kod źródłowy Firecrawl na GitHubie udostępniono na licencji AGPL-3.0. AGPL należy do tej samej rodziny co licencja GPL w oprogramowaniu open source i nakłada obowiązki przy udostępnianiu zmodyfikowanej wersji jako usługi.
Wersja samodzielna nie ma wszystkich funkcji chmury. Według dokumentacji wersji self-hosted bez dodatkowych usług nie obsługuje między innymi zrzutów ekranu, akcji na stronie ani zaawansowanej ochrony przed blokadami.
Od strony internetowej do bazy wiedzy chatbota
Najczęstszy scenariusz, z jakim przychodzą do nas firmy, to asystent AI odpowiadający na podstawie treści z serwisu i dokumentacji. Technicznie opiera się on na metodzie RAG w generatywnej AI: model nie odpowiada z pamięci, tylko najpierw wyszukuje pasujące fragmenty firmowych treści, a potem formułuje odpowiedź na ich podstawie. Firecrawl zajmuje się pierwszym etapem tego procesu.
Przebieg wygląda zwykle tak:
map - lista wszystkich adresów w serwisie, z której odrzuca się koszyk, logowanie, filtry i inne strony bez wartości merytorycznej,
crawl - pobranie wybranych podstron jako markdown z samą treścią główną,
podział na fragmenty - dłuższe teksty dzieli się na kawałki po kilka akapitów, z zachowaniem nagłówka i adresu źródła,
embeddingi - każdy fragment zamienia się na wektor liczb, który opisuje jego znaczenie,
zapis w bazie wektorowej - na przykład w bazie wektorowej Qdrant, gdzie system szuka fragmentów najbliższych pytaniu,
odpowiedź modelu - asystent dostaje kilka najlepszych fragmentów i odpowiada, podając źródło.
Czwarty i piąty krok to tak zwane wyszukiwanie oparte na embeddingach. Pozwala ono znaleźć odpowiedź na pytanie „ile trwa zwrot", nawet jeśli w treści strony padają słowa „termin na odesłanie towaru". Całość łatwo spiąć gotowymi bibliotekami. Firecrawl ma oficjalne integracje z popularnymi frameworkami, w tym z LlamaIndex do budowy aplikacji na danych i z LangChain. Dzięki temu prototyp takiego asystenta powstaje szybko, a czas projektu idzie w to, co naprawdę decyduje o jakości: dobór stron, podział na fragmenty i testy odpowiedzi.
Tak przygotowana baza zasila potem chatbota AI na stronie lub w aplikacji. Treści trzeba jednak odświeżać. Firecrawl domyślnie korzysta z pamięci podręcznej i może zwrócić wersję strony pobraną wcześniej, według dokumentacji nawet sprzed dwóch dni, chyba że w zapytaniu ustawi się inną wartość. Przy cennikach czy stanach magazynowych to istotna różnica.
Ekstrakcja danych w formacie JSON
Drugi typ zastosowań to wyciąganie konkretnych pól zamiast całej treści. Zamiast pisać reguły dla każdej strony, opisuje się, czego się szuka: nazwa produktu, cena, dostępność, producent. Firecrawl przekazuje stronę modelowi językowemu, a ten zwraca dane zgodne z podanym schematem, czyli opisem pól i ich typów. Przykład z praktyki: firma handlowa chce codziennie sprawdzać ceny kilkuset produktów w kilku sklepach konkurencji. Tradycyjny scraper wymaga osobnych reguł dla każdego sklepu i poprawek po każdej zmianie wyglądu strony. Ekstrakcja przez model działa na wszystkich sklepach tym samym schematem. Jest wolniejsza i droższa w przeliczeniu na stronę, ale znacznie tańsza w utrzymaniu.
Z takich danych korzysta się potem przy analizie konkurencji w branży technologicznej i handlowej, przy zbieraniu ofert z portali branżowych albo przy uzupełnianiu danych o firmach w CRM. Firecrawl ma też funkcję śledzenia zmian, która porównuje stronę z poprzednią wersją i pokazuje, co się zmieniło. Przydaje się przy monitoringu regulaminów, cenników czy ofert pracy. Model może się pomylić. Przy danych, od których zależą decyzje, każdy wynik powinien przechodzić przez walidację: czy cena jest liczbą, czy mieści się w rozsądnym zakresie, czy nie różni się od wczorajszej o rząd wielkości. Te reguły pisze się raz i oszczędzają wiele nieprzyjemnych niespodzianek.
Firecrawl w rękach agenta AI
Agent AI to program, który sam planuje kolejne kroki i korzysta z narzędzi, żeby wykonać zadanie. Podobnie działa Agent ChatGPT w przeglądarce. Firecrawl bywa jednym z takich narzędzi: agent wyszukuje informacje w sieci, pobiera treść kilku stron i dopiero na tej podstawie przygotowuje odpowiedź lub raport. Najprościej podłącza się go przez Model Context Protocol (MCP), czyli standard, który pozwala asystentom AI korzystać z zewnętrznych narzędzi w jednolity sposób. Firecrawl udostępnia własny serwer MCP. Po podłączeniu asystent w edytorze kodu albo w aplikacji desktopowej może sam pobrać dokumentację biblioteki, sprawdzić zawartość strony klienta czy zebrać materiały do analizy.
Dostawca oferuje też własny tryb agenta, który na podstawie opisu zadania sam decyduje, jakie strony odwiedzić i jakie dane zebrać. To wygodne przy jednorazowych zadaniach badawczych. W procesach, które mają działać codziennie i dawać powtarzalne wyniki, zwykle lepiej sprawdza się jawnie zaprojektowany przepływ, w którym wiadomo, skąd pochodzi każda dana.
Pierwszy problem to strony zabezpieczone przed automatami. Część serwisów blokuje ruch z serwerów, wymaga logowania albo pokazuje weryfikację. Firecrawl w chmurze radzi sobie z wieloma takimi przypadkami, ale nie ze wszystkimi. Strony za logowaniem wymagają osobnego podejścia i sprawdzenia, czy regulamin serwisu w ogóle pozwala na takie pobieranie. Drugi to jakość markdown. Automatyczne wykrywanie treści głównej działa dobrze na artykułach i opisach produktów, gorzej na stronach z nietypowym układem, rozbudowanymi tabelami czy treścią w zakładkach. Na początku projektu trzeba przejrzeć wyniki dla kilkudziesięciu reprezentatywnych stron i dopiero wtedy ustawić parametry, na przykład listę elementów do pominięcia. Trzeci to zasady samych serwisów. Według twórców Firecrawl domyślnie respektuje plik robots.txt, w którym właściciel strony określa, co roboty mogą pobierać. Odpowiedzialność za to, jakie treści się pobiera i do czego ich się używa, zostaje po stronie firmy, która uruchamia crawler. Czwarty problem jest organizacyjny. Pobranie danych to początek. Ktoś musi odpowiadać za harmonogram odświeżania, monitorowanie błędów i reakcję, gdy liczba pobranych stron nagle spadnie o połowę. Bez tego baza wiedzy chatbota po kilku miesiącach po cichu się dezaktualizuje.
Ile kosztuje Firecrawl i kiedy wybrać inne narzędzie
Wersja w chmurze rozliczana jest w kredytach. Według cennika Firecrawl, sprawdzonego we wrześniu 2026 roku, pobranie jednej strony przez scrape, crawl lub map kosztuje 1 kredyt, a formaty oparte na modelu językowym, takie jak JSON, dodają 4 kredyty na stronę. Darmowy plan obejmuje 1000 kredytów miesięcznie, a płatne zaczynają się od kilkunastu dolarów miesięcznie przy rozliczeniu rocznym. Ceny zmieniają się, więc przed decyzją trzeba je sprawdzić u źródła. W praktyce przy bazie wiedzy z kilkuset podstron koszt samego pobierania jest niewielki w porównaniu z pracą zespołu. Rachunek zmienia się przy dużej skali, na przykład przy codziennym monitoringu dziesiątek tysięcy produktów z ekstrakcją JSON. Wtedy trzeba policzyć, czy nie opłaca się część pracy wykonać tańszym sposobem.
Alternatywy są dwie. Pierwsza to własny scraper, na przykład oparty na frameworku Scrapy do pobierania danych w Pythonie. Daje pełną kontrolę i niski koszt jednostkowy, ale wymaga więcej pracy przy każdej zmianie źródła. Strony mocno oparte na skryptach obsługuje się wtedy przeglądarką sterowaną kodem, na przykład narzędziem Playwright do automatyzacji przeglądarki. Drugą alternatywą jest samodzielnie uruchomiony Firecrawl, który eliminuje opłaty za kredyty, ale przenosi na firmę utrzymanie serwerów i nie ma części funkcji wersji chmurowej.
Najczęściej zaczynamy od wersji w chmurze i pilotażu na małym zakresie. Kiedy wiadomo już, które strony, jak często i w jakim formacie są potrzebne, łatwiej zdecydować, czy zostać przy niej, czy przenieść część procesu do własnego rozwiązania.
FAQ
FAQ - Najczęściej zadawane pytania o Firecrawl
Tak, Firecrawl ma darmowy plan w chmurze oraz wersję open source, którą można uruchomić na własnym serwerze bez opłat licencyjnych. Darmowy plan w chmurze obejmuje według cennika z września 2026 roku 1000 kredytów miesięcznie, co odpowiada mniej więcej tysiącowi pobranych stron w podstawowym formacie. Wystarcza to do testów, prototypu asystenta AI na treściach z małego serwisu albo jednorazowego pobrania dokumentacji. Wersja open source nie ma limitu kredytów, ale wymaga własnej infrastruktury, a część funkcji dostępnych w chmurze, takich jak zrzuty ekranu czy akcje na stronie, działa w niej dopiero po dołączeniu dodatkowych usług. Wybór zależy od liczby stron do pobierania, częstotliwości odświeżania i tego, czy firma ma zespół, który utrzyma własny serwer.
Koszt zależy od liczby podstron i wybranego formatu, a przy typowym serwisie firmowym mieści się zwykle w darmowym limicie lub najtańszym płatnym planie. W chmurze Firecrawl jedna pobrana strona w formacie markdown kosztuje 1 kredyt, a ekstrakcja danych do formatu JSON z użyciem modelu językowego dodaje kolejne 4 kredyty na stronę. Serwis z kilkuset podstronami pobrany raz w markdown zużyje więc kilkaset kredytów, a codzienne pobieranie kilku tysięcy stron z ekstrakcją JSON wymaga już wyższego planu. Do kosztu narzędzia dochodzi koszt przetwarzania danych w modelu AI i bazie wektorowej, jeśli treści mają zasilać asystenta. Ostateczna kwota zależy od liczby stron, częstotliwości odświeżania, używanych formatów i tego, czy część stron da się pominąć, bo nie wnosi treści merytorycznej.
Tak, Firecrawl uruchamia skrypty na stronie przed pobraniem treści, więc radzi sobie ze stronami, które budują zawartość w przeglądarce, na przykład w React, Vue czy Angular. Zwykłe pobranie kodu HTML takiej strony często zwraca prawie pusty dokument, bo treść pojawia się dopiero po wykonaniu JavaScriptu. Firecrawl czeka na załadowanie strony, a w razie potrzeby można ustawić dodatkowy czas oczekiwania albo zlecić akcje, takie jak kliknięcie przycisku „pokaż więcej” czy przewinięcie listy. Przykładowo katalog produktów doładowujący kolejne pozycje przy przewijaniu da się pobrać w całości, jeśli w zapytaniu zaplanuje się przewinięcia. Skuteczność zależy od złożoności strony, zabezpieczeń przed automatami i tego, czy treść nie jest ukryta za logowaniem.
Tak, Firecrawl można połączyć z asystentami AI, takimi jak Claude czy aplikacje oparte na modelach OpenAI, najczęściej przez serwer MCP lub przez API w kodzie aplikacji. MCP, czyli Model Context Protocol, to standard, dzięki któremu asystent może samodzielnie wywołać zewnętrzne narzędzie, na przykład pobrać stronę albo wyszukać informacje w sieci, i od razu wykorzystać wynik w odpowiedzi. Firecrawl udostępnia własny serwer MCP, więc podłączenie go do obsługujących ten standard aplikacji zajmuje zwykle kilka minut. W aplikacjach budowanych na zamówienie Firecrawl wywołuje się przez API lub oficjalne biblioteki dla Pythona i Node.js, a pobrane treści przekazuje modelowi jako kontekst. Wybór sposobu zależy od tego, czy chodzi o narzędzie dla pojedynczego pracownika, czy o funkcję w produkcie dla klientów.
Tak, Firecrawl potrafi pobierać pliki PDF dostępne na stronach i zamieniać je na tekst w formacie markdown, a osobna funkcja parsowania obsługuje także lokalne pliki PDF, DOCX czy XLSX. Dzięki temu cenniki, karty produktów, regulaminy czy instrukcje opublikowane jako dokumenty mogą trafić do tej samej bazy wiedzy co zwykłe podstrony. Przykładowo producent maszyn może zasilić asystenta serwisowego zarówno treściami ze strony, jak i instrukcjami obsługi w PDF, a asystent w odpowiedzi wskaże konkretny dokument. W chmurze przetwarzanie PDF jest dodatkowo płatne w kredytach za każdą stronę dokumentu. Jakość wyniku zależy od samego pliku: dokumenty tekstowe konwertują się dobrze, a skany, złożone tabele i wielokolumnowy układ mogą wymagać dodatkowej obróbki.
Tak, pobieranie danych przez Firecrawl można uruchamiać cyklicznie, a dostawca oferuje też funkcję śledzenia zmian, która porównuje stronę z jej poprzednią wersją. W typowym wdrożeniu harmonogram, na przykład codzienny lub cotygodniowy, uruchamia pobieranie wybranych stron, a system aktualizuje w bazie wiedzy tylko te fragmenty, które się zmieniły. Trzeba przy tym pamiętać o pamięci podręcznej: Firecrawl domyślnie może zwrócić wersję strony pobraną wcześniej, więc przy danych wymagających świeżości ustawia się w zapytaniu krótszy dopuszczalny wiek wyniku. Przykładowo cennik konkurencji można sprawdzać codziennie rano, a dokumentację produktu raz w tygodniu. Częstotliwość zależy od tego, jak często zmieniają się źródła, jak szybko nieaktualna informacja staje się problemem i ile kredytów można przeznaczyć na odświeżanie.
Tak, Firecrawl jest projektem open source na licencji AGPL-3.0 i można go uruchomić na własnej infrastrukturze, najczęściej w kontenerach Docker. Takie rozwiązanie wybierają firmy, które chcą, żeby pobierane dane nie przechodziły przez zewnętrzną usługę, albo przetwarzają tak dużo stron, że opłaty za kredyty stają się istotne. Wersja samodzielna nie ma jednak wszystkich funkcji chmury: bez dodatkowych usług nie obsługuje zaawansowanego omijania blokad, zrzutów ekranu ani akcji na stronie, a funkcje oparte na modelach językowych wymagają podłączenia własnego dostawcy, na przykład OpenAI lub modelu uruchamianego lokalnie. Trzeba też wziąć pod uwagę warunki licencji AGPL, jeśli zmodyfikowana wersja ma być udostępniana innym jako usługa. Opłacalność zależy od skali pobierania, wymagań dotyczących danych i kosztu utrzymania serwerów.
Prototyp chatbota odpowiadającego na podstawie treści ze strony można zbudować w ciągu kilku dni, a wersja gotowa do udostępnienia klientom powstaje zwykle w kilka tygodni do kilku miesięcy. Samo pobranie treści przez Firecrawl zajmuje od minut do godzin, zależnie od wielkości serwisu. Najwięcej czasu pochłania dobór stron, podział treści na fragmenty, testy odpowiedzi na prawdziwych pytaniach klientów, zabezpieczenie przed odpowiadaniem na tematy spoza oferty i projekt interfejsu. Przykładowo asystent dla sklepu z kilkuset produktami i stroną pomocy wymaga mniej pracy niż asystent łączący serwis, dokumentację techniczną w PDF i dane z systemu zamówień. Harmonogram zależy od liczby źródeł, wymagań co do jakości odpowiedzi, integracji z innymi systemami i liczby języków.
Sztuczna inteligencja rozwija się w błyskawicznym tempie, a jednym z jej najnowszych i najbardziej obiecujących osiągnięć jest technologia RAG (Retrieval-Augmented Generation). To innowacyjne podejście łączy możliwości generowania tekstu przez AI z dynamicznym wyszukiwaniem informacji w zewnętrznych źródłach. Dzięki temu odpowiedzi są nie tylko poprawne językowo, ale także aktualne i oparte na zweryfikowanych danych.
Codziennie korzystamy z wyszukiwarek – czy to w internecie, czy w firmowych bazach wiedzy – oczekując szybkiego i trafnego dostępu do informacji. Tradycyjne metody oparte na słowach kluczowych często zawodzą, bo nie rozumieją kontekstu ani intencji użytkownika. Rozwiązaniem tego problemu stało się Embedding-Based Retrieval, czyli inteligentne wyszukiwanie oparte na wektorowych reprezentacjach danych.
Web scraping to technika pozyskiwania danych z stron internetowych. Polega na przeszukiwaniu kodu HTML i wyodrębnieniu żądanych informacji. Najczęściej stosuje się ją w celach badawczych lub biznesowych. Istnieją specjalne narzędzia ułatwiające tę pracę, ale proces może być też wykonany ręcznie.
W świecie sztucznej inteligencji coraz większą rolę odgrywają duże modele językowe (LLM), które potrafią generować tekst, odpowiadać na pytania czy analizować dane w naturalnym języku. Tworzenie praktycznych aplikacji opartych na LLM wymaga jednak nie tylko modelu, ale także odpowiedniej logiki, integracji z danymi i narzędziami oraz zarządzania kontekstem rozmowy.
Sztuczna inteligencja w ostatnich latach zmieniła sposób, w jaki pracujemy, komunikujemy się i zarządzamy informacjami. Jednym z najnowszych i najbardziej obiecujących rozwiązań są tzw. Agenci AI, którzy potrafią nie tylko odpowiadać na pytania, ale także samodzielnie wykonywać konkretne zadania. Wśród nich szczególne miejsce zajmuje Agent ChatGPT, który łączy moc modeli językowych z praktycznymi funkcjami automatyzacji i integracji.
W świecie technologii, gdzie język staje się kluczem do interakcji między człowiekiem a maszyną, modelowanie językowe odgrywa kluczową rolę. Czy kiedykolwiek zastanawiałeś się, jak optymalizować duże modele językowe? Poznaj LLMO - rewolucyjny krok w dziedzinie modelowania językowego. Optymalizacja pod duże modele językowe otwiera nowe możliwości i perspektywy.