LangSmith od podstaw: monitorowanie, testowanie i debugowanie aplikacji LLM
LangSmith to platforma do śledzenia, testowania i monitorowania aplikacji opartych na modelach językowych. Wyjaśniamy od podstaw, co pokazuje trace, jak budować zbiory testowe i ewaluacje, ile kosztuje narzędzie i kiedy lepiej wybrać alternatywę, taką jak Langfuse.
W zwykłej aplikacji błąd ma adres. Jest komunikat, numer linii w kodzie, dane wejściowe, które da się odtworzyć. W aplikacji opartej na modelu językowym tego często brak: asystent w poniedziałek odpowiada dobrze, we wtorek na podobne pytanie wymyśla nieistniejący punkt regulaminu, a w logach serwera widać tylko, że zapytanie zakończyło się sukcesem. LangSmith rozwiązuje właśnie ten problem, a w tym tekście wyjaśniamy go od podstaw. Narzędzie pokazuje, co działo się wewnątrz aplikacji LLM krok po kroku, pozwala ją testować przed wdrożeniem i monitorować, gdy już pracuje z użytkownikami.
Narzędzie rozwija firma LangChain, autorka popularnych bibliotek do budowy aplikacji z modelami językowymi. W październiku 2025 r. spółka pozyskała 125 mln dolarów przy wycenie 1,25 mld, a LangSmith jest jej głównym produktem komercyjnym.
Dlaczego aplikacje LLM trudno debugować
Aplikacja z modelem językowym rzadko jest jednym zapytaniem do API. Typowy asystent obsługi klienta najpierw przeformułowuje pytanie, potem wyszukuje fragmenty dokumentów w bazie wiedzy, składa z nich instrukcję dla modelu, wywołuje model, czasem prosi go o użycie narzędzia, a na końcu sprawdza odpowiedź. Każdy z tych kroków może pójść źle. Do tego dochodzi niedeterminizm. Ten sam model z tym samym pytaniem potrafi odpowiedzieć inaczej przy kolejnym wywołaniu. Zmiana jednego słowa w instrukcji poprawia odpowiedzi w jednym typie pytań i psuje w innym. Bez narzędzi zespół dowiaduje się o tym od klientów. Trzeci problem to koszt i czas. Każde wywołanie modelu kosztuje, a długi łańcuch kroków potrafi trwać kilkanaście sekund. Żeby wiedzieć, który krok odpowiada za rachunek i opóźnienie, trzeba go zmierzyć. Tak powstała cała kategoria narzędzi nazywana LLM observability, czyli obserwowalnością aplikacji opartych na dużych modelach językowych.
Czym jest LangSmith i jak zacząć od podstaw
LangSmith to platforma działająca w chmurze (lub, w planie Enterprise, na własnej infrastrukturze), do której aplikacja wysyła informacje o każdym swoim uruchomieniu. Zespół ogląda je w przeglądarce, buduje na ich podstawie testy i pulpity z metrykami. Mimo nazwy nie trzeba używać biblioteki LangChain. Aplikacje zbudowane w LangChain lub LangGraph wysyłają dane po ustawieniu kilku zmiennych środowiskowych. Pozostałe, napisane bezpośrednio na SDK OpenAI, Anthropic, Vercel AI SDK czy innych frameworkach, podłącza się przez bibliotekę LangSmith albo standard OpenTelemetry. Pierwsze dane pojawiają się w panelu zwykle po kilkunastu minutach pracy programisty.
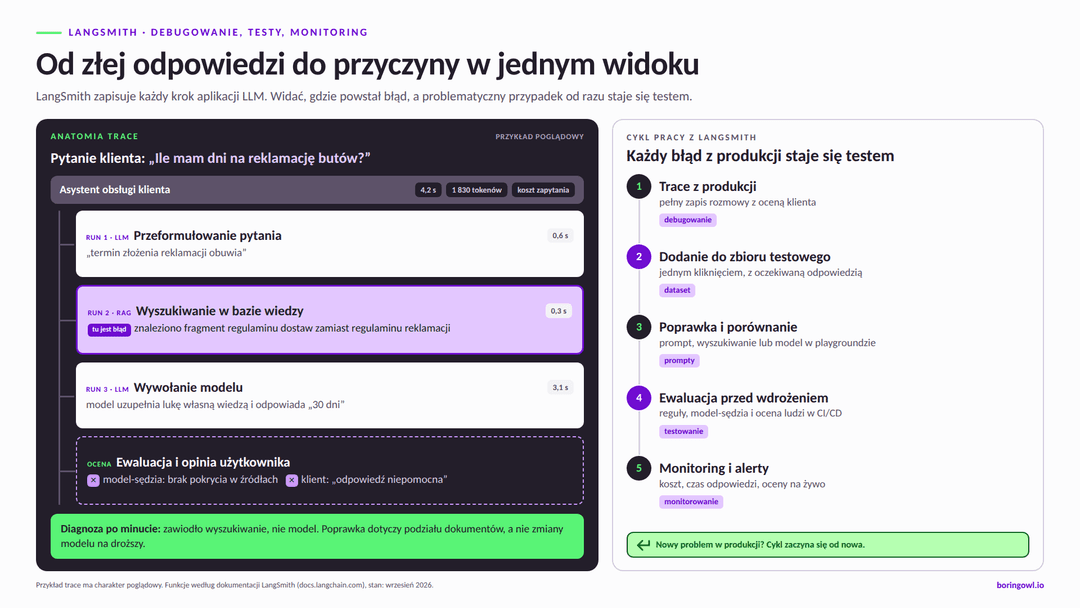
Podstawowe pojęcia są dwa. Trace to zapis jednego pełnego uruchomienia aplikacji, na przykład odpowiedzi na jedno pytanie użytkownika. Run to pojedynczy krok w jego wnętrzu: wyszukiwanie w dokumentach, wywołanie modelu, użycie narzędzia. Trace składa się z runów ułożonych w drzewo.
Debugowanie: co widać w pojedynczym trace
Wróćmy do asystenta, który wymyślił punkt regulaminu. W LangSmith zespół otwiera trace tej rozmowy i widzi całą drogę odpowiedzi. Jakie pytanie zadał użytkownik. Jak aplikacja je przeformułowała. Które fragmenty dokumentów znalazło wyszukiwanie i z jaką oceną trafności. Jaką pełną instrukcję dostał model i co dokładnie odpowiedział.
Najczęściej przyczyna jest widoczna po minucie. Wyszukiwanie nie znalazło właściwego fragmentu, więc model uzupełnił lukę własną wiedzą. To nie jest błąd modelu, tylko wyszukiwania w mechanizmie RAG, więc poprawka dotyczy podziału dokumentów albo sposobu wyszukiwania, a nie zmiany modelu na droższy.
Przy każdym kroku LangSmith pokazuje też liczbę tokenów, koszt i czas wykonania. W aplikacjach z agentami, które same decydują o kolejnych krokach, to często jedyny sposób, żeby zobaczyć, dlaczego jedna rozmowa kosztowała dziesięć razy więcej niż zwykle: agent wpadł w pętlę i wywołał to samo narzędzie kilkanaście razy. Przy agentach budowanych w LangGraph widok obejmuje również przejścia między węzłami grafu i przekazania zadań między agentami.
Testowanie: zbiory danych i ewaluacje
Debugowanie pojedynczych przypadków nie wystarcza. Po poprawce trzeba wiedzieć, czy nie zepsuła niczego innego. Do tego służą zbiory danych (datasets) i ewaluacje.
Zbiór danych to lista przykładowych wejść, najczęściej z oczekiwanymi odpowiedziami: kilkadziesiąt lub kilkaset pytań, na które aplikacja musi odpowiadać poprawnie. Najlepsze przykłady pochodzą z produkcji. W LangSmith trace problematycznej rozmowy można jednym kliknięciem dodać do zbioru, żeby przy każdej kolejnej zmianie sprawdzać, czy błąd nie wrócił. To odpowiednik testów regresji w klasycznym oprogramowaniu.
Ewaluacja uruchamia aplikację na całym zbiorze i ocenia wyniki. Ocenę mogą wystawiać różne mechanizmy:
reguły w kodzie, na przykład sprawdzenie, czy odpowiedź zawiera link do źródła albo nie przekracza określonej długości,
inny model językowy w roli sędziego (LLM-as-judge), który ocenia trafność, zgodność z dokumentami lub ton wypowiedzi,
ludzie, którzy oceniają wybrane odpowiedzi w kolejkach adnotacji,
porównanie dwóch wersji aplikacji na tych samych pytaniach, gdy nie ma jednej poprawnej odpowiedzi.
Wyniki kolejnych eksperymentów trafiają do jednej tabeli, więc widać, że nowa wersja instrukcji podniosła trafność odpowiedzi o reklamacje, ale obniżyła w pytaniach o dostawę. Ewaluacje da się też uruchamiać automatycznie w potoku CI/CD, tak by zmiana promptu lub modelu nie trafiła do produkcji bez sprawdzenia. Z badania LangChain o stanie agentów AI, przeprowadzonego pod koniec 2025 r. na 1340 respondentach, wynika, że offline'owe ewaluacje na zbiorach testowych prowadzi 52,4% organizacji, a jakość odpowiedzi jest najczęściej wskazywaną barierą przed wdrożeniem agentów na produkcję. Dane pochodzą od producenta LangSmith, więc warto czytać je z tą świadomością, ale kierunek jest wyraźny.
Po wdrożeniu LangSmith zbiera trace z prawdziwego ruchu. Na ich podstawie buduje pulpity z liczbą zapytań, czasem odpowiedzi, kosztami, odsetkiem błędów i ocenami użytkowników. Można ustawić alerty, na przykład gdy średni czas odpowiedzi przekroczy kilka sekund albo koszt dzienny nagle wzrośnie. Część ewaluacji działa też na żywo (online evaluations). Wybrany odsetek rozmów jest automatycznie oceniany przez model-sędziego, a rozmowy z niską oceną trafiają do kolejki, którą przegląda człowiek. W chatbotach obsługujących klientów warto połączyć to z przyciskiem „pomocna odpowiedź / niepomocna” w interfejsie. Każda ocena użytkownika zostaje przypięta do konkretnego trace, więc od negatywnej opinii do przyczyny jest jedno kliknięcie.
W 2026 r. LangChain dodał moduł Engine, który samodzielnie przegląda trace, grupuje powtarzające się problemy i proponuje poprawki. Według komunikatu producenta z września 2026 r. od premiery w maju narzędzie przeanalizowało ponad 60 mln trace. To przydatne przy dużym ruchu, gdzie ręczne przeglądanie rozmów przestaje być możliwe. Przy mniejszej skali wystarczą dobrze ustawione ewaluacje i regularny przegląd próbek.
Prompty, modele i porównania
Czwarty obszar LangSmith to praca z instrukcjami dla modeli. Playground pozwala otworzyć dowolny krok z trace, zmienić prompt albo model i od razu zobaczyć nową odpowiedź na tych samych danych. Prompt Hub przechowuje wersje promptów, dzięki czemu wiadomo, która wersja działała w produkcji w danym dniu, a zmianę da się cofnąć. Dla firmy ma to wymiar finansowy. Na zbiorze testowym można porównać droższy i tańszy model albo modele różnych dostawców, na przykład Claude od Anthropic i modele OpenAI, i sprawdzić, czy różnica w jakości uzasadnia różnicę w cenie. Wiele zadań, takich jak klasyfikacja zgłoszeń czy wyciąganie danych z dokumentów, tańszy model wykonuje równie dobrze. Tę decyzję lepiej podejmować na liczbach niż na wrażeniu z kilku rozmów.
Dobre instrukcje zmniejszają zresztą różnice między modelami, co pokazują zasady prompt engineeringu.
LangSmith nie jest jedynym narzędziem tego typu. Najczęściej porównuje się go z Langfuse, otwartym narzędziem do monitorowania LLM, a także z Arize Phoenix czy Helicone. Funkcje są podobne: tracing, zbiory danych, ewaluacje, zarządzanie promptami. Różnice leżą gdzie indziej.
LangSmith jest najwygodniejszy w projektach opartych na LangChain i LangGraph, bo integracja działa od razu, a widoki są dopasowane do agentów budowanych w tym ekosystemie. Według cennika LangChain plan Developer jest bezpłatny dla jednej osoby i obejmuje 5 tys. trace miesięcznie, plan Plus kosztuje 39 dolarów za użytkownika miesięcznie z 10 tys. trace w cenie, a za większy ruch płaci się według zużycia. Wersja instalowana na własnych serwerach jest dostępna tylko w planie Enterprise.
Langfuse ma kod otwarty i można go bezpłatnie uruchomić na własnym serwerze. To istotne, gdy rozmowy z klientami zawierają dane, które nie mogą opuszczać infrastruktury firmy, albo gdy ruch jest duży, a budżet na narzędzia ograniczony. W zamian zespół sam odpowiada za utrzymanie tej instalacji.
W praktyce wybór rzadko przesądza o sukcesie projektu. Ważniejsze jest, żeby jakiekolwiek narzędzie do obserwowalności pojawiło się od pierwszego dnia, a nie po pierwszej reklamacji klienta.
FAQ
FAQ - Najczęściej zadawane pytania o LangSmith
Tak, LangSmith ma bezpłatny plan Developer, który wystarcza do nauki, prototypów i małych projektów. Obejmuje jedno konto użytkownika i 5 tys. zapisanych uruchomień aplikacji (trace) miesięcznie, przechowywanych standardowo przez 14 dni, a po przekroczeniu limitu płaci się według zużycia. W tym planie dostępne są podstawowe funkcje: śledzenie działania aplikacji, zbiory testowe, ewaluacje i praca z promptami. Plan przestaje wystarczać, gdy z narzędzia ma korzystać kilka osób albo aplikacja obsługuje większy ruch produkcyjny. Wtedy trzeba przejść na plan Plus lub Enterprise, a koszt zależy od liczby użytkowników, liczby zapisywanych trace i długości ich przechowywania.
Tak, LangSmith można używać z aplikacjami napisanymi bez LangChain, na przykład bezpośrednio na SDK OpenAI lub Anthropic, w Vercel AI SDK czy w innych frameworkach do budowy agentów. Integracja odbywa się przez bibliotekę LangSmith dla Pythona i TypeScriptu, w której wystarczy opakować wybrane funkcje, albo przez standard OpenTelemetry, jeśli aplikacja już go używa. Przykładowo w aplikacji wywołującej API OpenAI wystarczy owinąć klienta funkcją z SDK LangSmith, żeby każde zapytanie do modelu pojawiło się w panelu. Najwygodniejsza integracja dotyczy jednak LangChain i LangGraph, gdzie dane są wysyłane automatycznie po ustawieniu zmiennych środowiskowych. Nakład pracy zależy od tego, ile kroków aplikacji ma być widocznych w trace.
Tak, LangSmith jest dostępny w wersji instalowanej na własnej infrastrukturze, ale wyłącznie w planie Enterprise. Oprócz pełnej instalacji na serwerach firmy producent oferuje też model hybrydowy, w którym dane zostają w infrastrukturze klienta, a część usług działa w chmurze LangChain. Taka konfiguracja ma sens, gdy trace zawierają dane klientów, które nie mogą opuszczać firmowej sieci, lub gdy wymagają tego umowy z klientami. Dla mniejszych firm, które potrzebują samodzielnej instalacji bez kontraktu Enterprise, alternatywą jest Langfuse, dostępny na otwartej licencji. Wybór zależy od budżetu, wymagań dotyczących danych i gotowości zespołu do utrzymania własnej instalacji.
Samo podłączenie śledzenia zajmuje zwykle od kilku godzin do jednego dnia, a zbudowanie sensownych testów i monitoringu od jednego do kilku tygodni. W aplikacjach opartych na LangChain lub LangGraph pierwsze trace pojawiają się po ustawieniu kilku zmiennych środowiskowych, a w pozostałych trzeba dodać wywołania SDK w odpowiednich miejscach kodu. Więcej czasu wymaga przygotowanie zbioru testowego z oczekiwanymi odpowiedziami, dobranie ewaluacji i ustawienie alertów, bo wymaga to udziału osób znających proces biznesowy. Czas zależy od złożoności aplikacji, liczby kroków i narzędzi, z których korzysta, oraz od tego, czy firma ma już zdefiniowane kryteria dobrej odpowiedzi.
Tak, LangSmith pokazuje pełny przebieg pracy agentów AI, w tym kolejne wywołania modelu, użyte narzędzia, przekazania zadań między agentami i całe rozmowy składające się z wielu wiadomości. Rozmowy są grupowane w wątki, więc da się prześledzić, w którym momencie dłuższa konwersacja zeszła na niewłaściwy tor. Narzędzie pozwala też oceniać całe rozmowy, a nie tylko pojedyncze odpowiedzi, na przykład sprawdzać, czy agent ostatecznie rozwiązał problem klienta. W 2026 r. dodano widok, który układa sesję agenta chronologicznie, łącznie z pracą podagentów. Przydatność tych funkcji rośnie wraz z liczbą kroków, które agent wykonuje samodzielnie.
Tak, LangSmith pozwala ukryć lub zamaskować wrażliwe dane, zanim trafią do zapisu. W konfiguracji SDK można całkowicie wyłączyć zapisywanie treści wejść i wyjść, zachowując tylko metadane, takie jak czas odpowiedzi i koszt, albo zdefiniować reguły, które zamieniają na przykład numery telefonów, adresy e-mail czy numery PESEL na znaczniki. Dzięki temu zespół nadal widzi strukturę działania aplikacji i może diagnozować problemy, nie przechowując danych klientów w narzędziu zewnętrznym. Zakres maskowania trzeba jednak dobrać rozsądnie: zbyt agresywne ukrywanie utrudnia debugowanie. Wybór zależy od rodzaju danych, które pojawiają się w rozmowach, i od wymagań firmy dotyczących ich przetwarzania.
Tak, LangSmith pozwala wykrywać halucynacje za pomocą ewaluacji, najczęściej z użyciem innego modelu językowego w roli sędziego, który porównuje odpowiedź z dokumentami znalezionymi przez aplikację. Taki ewaluator sprawdza, czy każda informacja w odpowiedzi ma pokrycie w źródłach, i obniża ocenę, gdy model dopisał coś od siebie, na przykład nieistniejący termin reklamacji. Ewaluację można uruchamiać na zbiorze testowym przed wdrożeniem oraz na żywo, na wybranym odsetku rozmów produkcyjnych. Model-sędzia też się myli, dlatego jego ocenę warto regularnie porównywać z oceną człowieka na próbce przypadków. Skuteczność wykrywania zależy od jakości instrukcji dla sędziego i od tego, czy aplikacja zapisuje w trace użyte źródła.
W świecie AI, duże modele językowe (LLM) stają się kluczowym elementem ewolucji. Pozwalają maszynom na naturalne 'rozumienie' i generowanie języka ludzkiego. Na czym jednak polega ich działanie? Jak wpłynęły na przełom w sztucznej inteligencji? Sprawdźmy to!
W świecie sztucznej inteligencji coraz większą rolę odgrywają duże modele językowe (LLM), które potrafią generować tekst, odpowiadać na pytania czy analizować dane w naturalnym języku. Tworzenie praktycznych aplikacji opartych na LLM wymaga jednak nie tylko modelu, ale także odpowiedniej logiki, integracji z danymi i narzędziami oraz zarządzania kontekstem rozmowy.
Sztuczna inteligencja rozwija się w błyskawicznym tempie, a jednym z jej najnowszych i najbardziej obiecujących osiągnięć jest technologia RAG (Retrieval-Augmented Generation). To innowacyjne podejście łączy możliwości generowania tekstu przez AI z dynamicznym wyszukiwaniem informacji w zewnętrznych źródłach. Dzięki temu odpowiedzi są nie tylko poprawne językowo, ale także aktualne i oparte na zweryfikowanych danych.
W dobie ogromnych ilości generowanych tekstów, zaawansowane narzędzia do analizy językowej stają się kluczowe dla skutecznego przetwarzania informacji. LangGraph jest nowoczesnym rozwiązaniem, które łączy innowacyjne grafowe modele reprezentacji danych z zaawansowanymi algorytmami przetwarzania języka naturalnego, oferując nowe możliwości w analizie semantycznej i syntaktycznej.
W dzisiejszych czasach, testowanie aplikacji jest jednym z najważniejszych etapów w projektowaniu oprogramowania. Jednym z rodzajów testów, który pozwala na sprawdzenie, czy w trakcie wprowadzania zmian do aplikacji, nie została naruszona wcześniej napisana funkcjonalność, są testy regresji. Jak się je przeprowadza? Dowiedz się więcej w artykule!
Komunikacja z modelami sztucznej inteligencji staje się nieodłączna w nowoczesnym świecie. Efektywna wymiana informacji między człowiekiem a AI to nie tylko zdolność do zrozumienia się nawzajem, ale także osiągnięcie wspólnego celu. Jak optymalizować ten proces? Odkryjmy razem sekrety efektywnej komunikacji z AI.