DuckDB - dlaczego analityczna baza danych działa bez serwera
DuckDB to analityczna baza danych, która działa wewnątrz aplikacji, bez serwera i bez administratora. Wyjaśniamy, skąd bierze się jej szybkość, jak czyta pliki CSV i Parquet bez importu, gdzie sprawdza się w firmie, czego nie zastąpi i co zmienia zapowiadany tryb serwera w wersji 2.0.
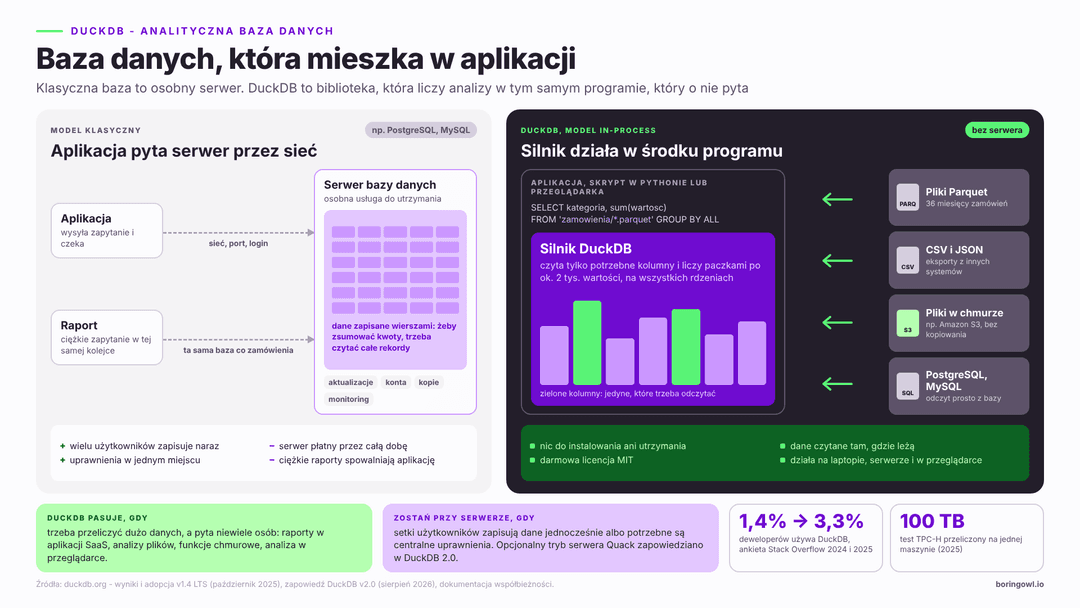
Gdy w firmie pada hasło „baza danych", większość osób wyobraża sobie serwer. Ktoś go instaluje, ktoś pilnuje aktualizacji, ktoś zakłada konta i płaci za maszynę w chmurze. DuckDB odwraca ten obraz. To analityczna baza danych, która nie ma serwera: jest biblioteką uruchamianą wewnątrz programu, który z niej korzysta, podobnie jak silnik w samochodzie nie jest osobnym pojazdem.
Brzmi jak zabawka dla programistów. Tymczasem ten sam silnik, uruchomiony na jednej mocnej maszynie, przeliczył w 2025 roku pełny test TPC-H na 100 terabajtach danych, a w ankiecie Stack Overflow odsetek deweloperów korzystających z DuckDB wzrósł z 1,4% w 2024 roku do 3,3% w 2025 roku (DuckDB, październik 2025). Według tego samego źródła sama paczka dla Pythona była wtedy pobierana prawie 25 milionów razy w miesiącu.
Baza danych, której nie trzeba instalować
Klasyczna baza, na przykład PostgreSQL, działa jak osobny urząd. Aplikacja wysyła do niej zapytanie przez sieć, czeka w kolejce i dostaje odpowiedź. Taki model ma zalety: wielu użytkowników naraz, uprawnienia, kopie zapasowe w jednym miejscu. Ma też koszt w postaci serwera, który trzeba utrzymać. DuckDB działa w modelu „in-process", czyli w tym samym procesie co program, który z niego korzysta. Skrypt w Pythonie czy aplikacja w Node.js dołącza bibliotekę i od tego momentu sama potrafi wykonywać zapytania SQL. Nie ma portu, logowania ani usługi do uruchomienia. Cała baza mieści się w jednym pliku albo wyłącznie w pamięci.
Projekt jest otwarty, na licencji MIT, a prawa do kodu należą do niezależnej fundacji DuckDB Foundation. Dla firmy oznacza to brak opłat licencyjnych i brak ryzyka, że dostawca zmieni warunki korzystania z samej bazy.
DuckDB vs SQLite - ten sam model, inne zadanie
DuckDB i SQLite działają w tym samym modelu in-process - żadna z nich nie potrzebuje serwera. Różnica dotyczy przeznaczenia. SQLite świetnie zapisuje i odczytuje pojedyncze rekordy, na przykład dane jednego użytkownika aplikacji. DuckDB powstał do odwrotnego zadania: przeliczania milionów wierszy naraz - typowy obszar OLAP - żeby odpowiedzieć na pytanie o marże w każdej kategorii przez trzy lata.
Szybkość bez serwera bierze się z budowy, nie z mocy maszyny
Bazy danych dzielą się z grubsza na dwa typy. Transakcyjne (OLTP) obsługują bieżącą pracę aplikacji: zamówienie, płatność, zmianę adresu. Analityczne odpowiadają na pytania o duże zbiory danych. DuckDB należy do drugiej grupy i zbudowano go pod ten jeden cel.
Pierwszy powód szybkości to zapis kolumnowy. Zwykła baza trzyma dane wierszami, jak kartoteka: cała karta klienta w jednym miejscu. DuckDB trzyma je kolumnami. Gdy pytamy o sumę sprzedaży, czyta tylko kolumnę z kwotami, a nie każdą kartę od początku do końca. Kolumny z podobnymi wartościami dobrze się też kompresują, więc z dysku czyta się mniej danych. Drugi powód to przetwarzanie wektorowe. Silnik nie liczy wiersz po wierszu, tylko paczkami po około dwa tysiące wartości, co lepiej wykorzystuje współczesne procesory. Do tego dochodzi praca na wszystkich rdzeniach naraz i umiejętność odkładania danych na dysk, gdy nie mieszczą się w pamięci.
Brak serwera nie oznacza braku gwarancji. DuckDB obsługuje transakcje ACID, czyli zapisuje zmiany w całości albo wcale, więc przerwany import nie zostawi bazy w połowie. Od wersji 1.4 potrafi też szyfrować plik bazy algorytmem AES-256 (DuckDB, wrzesień 2025).
Pliki CSV i Parquet bez importu
Najbardziej praktyczna cecha DuckDB dla firm nie ma wiele wspólnego z rekordami szybkości. Chodzi o to, że baza potrafi czytać dane bezpośrednio z plików: CSV, JSON i Parquet, czyli kolumnowego formatu plików używanego w analityce. Nie trzeba ich najpierw ładować do żadnego systemu. Wyobraźmy sobie sklep internetowy, który co miesiąc eksportuje zamówienia do pliku. Po trzech latach w folderze leży 36 plików i nikt nie chce ich sklejać w arkuszu. W DuckDB wystarczy jedno zapytanie:
SELECT kategoria, date_trunc('month', data_zamowienia) AS miesiac, sum(wartosc) AS sprzedaz
FROM 'zamowienia/*.parquet'
GROUP BY ALL
ORDER BY miesiac;
Gwiazdka w ścieżce oznacza „wszystkie pliki z tego folderu". Te same pliki mogą leżeć w chmurze, na przykład w Amazon S3, a DuckDB pobierze z nich tylko potrzebne kolumny. W wielu firmach to pozwala pominąć cały etap budowania procesów ETL, czyli przenoszenia i przekształcania danych do osobnej bazy, zanim ktokolwiek zada pierwsze pytanie.
Ten model dobrze współgra z podejściem data lake, w którym dane trzyma się w tanich plikach, a moc obliczeniową uruchamia dopiero wtedy, gdy jest potrzebna. DuckDB jest w nim silnikiem, który można włączyć na kilka sekund i wyłączyć.
Najlepsze zastosowania mają wspólny mianownik: dużo danych do przeliczenia, niewielu jednoczesnych użytkowników i potrzeba prostoty. W praktyce najczęściej są to:
raporty i statystyki wewnątrz aplikacji, na przykład w produkcie SaaS, gdzie każdy klient ogląda analizy tylko swoich danych,
przygotowanie danych w Pythonie zamiast biblioteki pandas, która przy dużych plikach potrafi zająć całą pamięć komputera,
przetwarzanie plików w funkcjach chmurowych, takich jak AWS Lambda, uruchamianych tylko wtedy, gdy przychodzi nowy plik,
analizy w przeglądarce użytkownika dzięki wersji DuckDB skompilowanej do WebAssembly, bez wysyłania danych na serwer,
mała, lokalna hurtownia danych dla zespołu analityków, zanim firma uzna, że potrzebuje rozwiązania w chmurze.
Pierwszy przypadek wart jest rozwinięcia. Raport w aplikacji często liczony jest na tej samej bazie, która obsługuje zamówienia. Gdy dane rosną, ciężkie zapytanie analityczne spowalnia całą aplikację, a tuning SQL pomaga tylko do pewnego momentu. Rozwiązanie z DuckDB polega na tym, że dane raportowe kopiuje się w nocy do plików Parquet, a moduł raportów liczy na nich. Baza transakcyjna przestaje być obciążana, a raport zwykle przyspiesza.
Wersja w przeglądarce też ma ciekawe zastosowania. Użytkownik wgrywa duży plik z danymi, a aplikacja filtruje go i liczy u niego na komputerze. Dla firmy to brak kosztów serwera, a dla klienta pewność, że dane nie opuściły jego urządzenia.
Czego DuckDB nie zastąpi
Brak serwera to zaleta, dopóki zadanie pasuje do tego modelu. Najważniejsze ograniczenie dotyczy zapisu. Do pliku bazy DuckDB w danej chwili może pisać tylko jeden proces. Wiele procesów może go jednocześnie czytać, ale aplikacja, w której setki użytkowników składają zamówienia, nie powinna trzymać ich w DuckDB. Do takiej pracy dalej służy baza transakcyjna, najczęściej PostgreSQL albo MySQL. W dobrze zaprojektowanym systemie obie bazy współpracują: transakcyjna przyjmuje zamówienia, a DuckDB liczy analizy na ich kopii. DuckDB potrafi zresztą czytać dane bezpośrednio z PostgreSQL i MySQL, więc ta kopia nie zawsze musi powstawać.
Drugie ograniczenie wynika z tej samej cechy. Skoro nie ma serwera, nie ma też centralnego miejsca, w którym administrator nadaje uprawnienia i widzi, kto czytał jakie dane. Jeśli dział finansów, marketing i zarząd mają pracować na wspólnych liczbach z różnymi poziomami dostępu, trzeba to rozwiązać w warstwie aplikacji albo wybrać inne narzędzie. Trzecie dotyczy skali organizacji, a nie danych. Pojedyncza maszyna z DuckDB poradzi sobie z setkami gigabajtów, a przy odpowiedniej mocy nawet z terabajtami. Nie zastąpi jednak platformy, z której kilkudziesięciu analityków korzysta jednocześnie, z historią zapytań, katalogiem danych i rozliczaniem kosztów między działami.
Jeden proces zapisujący - kluczowe ograniczenie architektury
Do pliku bazy DuckDB w danej chwili może pisać tylko jeden proces. Wiele procesów może go jednocześnie czytać, ale nie pisać. Przed wyborem DuckDB do nowego projektu warto sprawdzić, czy liczba jednoczesnych zapisów w systemie mieści się w tym modelu. Jeśli nie - lepsza jest klasyczna baza transakcyjna, a DuckDB może działać obok niej jako warstwa analityczna.
DuckDB 2.0 i opcjonalny tryb serwera
Twórcy DuckDB widzą te ograniczenia. W sierpniu 2026 roku zapowiedzieli wersję 2.0 z trybem klient-serwer o nazwie Quack. Jeden proces DuckDB może w nim udostępniać bazę przez sieć, a inne mogą się do niej podłączać i wysyłać zapytania (DuckDB, sierpień 2026).
Ważne jest słowo „opcjonalny". Model wbudowany w aplikację pozostaje podstawą, a tryb serwera to dodatek dla sytuacji, w których wiele procesów musi pisać do jednej bazy. W tej samej zapowiedzi pojawiły się nowy format zapisu, nowy parser SQL i szybsze odczyty danych z chmury. Wersja 2.0 ma się ukazać jesienią 2026 roku, więc przy nowych projektach trzeba sprawdzić, czy dana funkcja jest już w wersji stabilnej.
Osobno działa MotherDuck, komercyjna usługa chmurowa zbudowana na DuckDB. Daje wspólne bazy dla zespołu i uprawnienia, czyli to, czego brakuje w wersji wbudowanej. To dobra ścieżka dla firm, które zaczęły od lokalnych analiz i chcą je udostępnić szerzej bez budowania własnej infrastruktury.
To pytanie zadają najczęściej firmy, które słyszały o hurtowniach takich jak Snowflake i obawiają się ich kosztów. Odpowiedź zależy od trzech zmiennych: ilości danych, liczby osób, które z nich korzystają, i tego, jak często padają zapytania.
Hurtownia w chmurze rozlicza się zwykle za czas pracy mocy obliczeniowej i za przechowywanie danych. Ma sens, gdy wielu użytkowników pyta o dane przez cały dzień, a dane pochodzą z kilkunastu systemów. DuckDB uruchomiony w aplikacji czy w funkcji chmurowej kosztuje tyle, ile maszyna, na której działa, a często działa na maszynie już opłaconej. Przy kilku raportach dziennie i danych liczonych w dziesiątkach gigabajtów różnica w kosztach potrafi być duża. Podobnie wygląda porównanie z Apache Spark, który rozkłada obliczenia na wiele serwerów. Spark jest potrzebny przy naprawdę dużych zbiorach. Wiele firm uruchamia go jednak dla danych, które zmieściłyby się na jednym laptopie, i płaci za złożoność klastra bez realnej potrzeby.
Te narzędzia nie wykluczają się wzajemnie. DuckDB często trafia do firmy jako pierwszy krok: pozwala sprawdzić, jakie pytania biznes naprawdę zadaje danym. Dopiero na tej podstawie podejmuje się decyzję, czy potrzebna jest pełna platforma business intelligence z hurtownią w chmurze.
FAQ
FAQ - Najczęściej zadawane pytania o DuckDB
Tak, DuckDB jest udostępniany na licencji MIT, która pozwala używać go bezpłatnie także w produktach komercyjnych i zamkniętym oprogramowaniu. Licencja nie wymaga publikowania własnego kodu ani płacenia za liczbę użytkowników czy rdzeni procesora. Firma może na przykład wbudować DuckDB w swoją aplikację SaaS i sprzedawać ją klientom bez żadnych opłat dla twórców bazy. Koszty pojawiają się w innych miejscach: w pracy zespołu, który bazę wdraża i utrzymuje, w infrastrukturze, na której działa aplikacja, oraz w opcjonalnych usługach, takich jak płatne wsparcie dla starszych wersji czy komercyjna chmura MotherDuck.
Tak, DuckDB jest stabilnym projektem używanym produkcyjnie, także przez duże firmy, a od wersji 1.4 ma wydania z długim wsparciem (LTS). Wersje LTS otrzymują poprawki od społeczności przez rok, a później można wykupić rozszerzone wsparcie. Produkcyjnie DuckDB działa najczęściej jako silnik raportów w aplikacjach, element przetwarzania danych w potokach analitycznych albo narzędzie w funkcjach chmurowych. Czy sprawdzi się w konkretnym systemie, zależy od charakteru obciążenia: przy analizach dużych zbiorów z jednym procesem zapisującym działa bardzo dobrze, a przy wielu jednoczesnych zapisach od różnych użytkowników lepszym wyborem jest klasyczna baza transakcyjna.
Tak, DuckDB odczytuje pliki .xlsx za pomocą oficjalnego rozszerzenia excel, a wynik można przetwarzać zwykłym SQL-em razem z innymi danymi. Dzięki temu da się na przykład połączyć arkusz z planem sprzedaży przygotowanym przez handlowców z rzeczywistymi zamówieniami zapisanymi w plikach Parquet i policzyć realizację planu jednym zapytaniem. Ten sam mechanizm pozwala też zapisać wynik analizy z powrotem do pliku Excel. Jakość efektu zależy głównie od samego arkusza: scalone komórki, kilka tabel na jednej zakładce czy nagłówki w kilku wierszach wymagają wcześniejszego uporządkowania albo wskazania dokładnego zakresu danych.
DuckDB obsługuje zbiory większe niż pamięć RAM komputera, bo nadmiarowe dane odkłada na dysk, więc granica zależy przede wszystkim od sprzętu i rodzaju zapytań. Na typowym laptopie z kilkunastoma lub kilkudziesięcioma gigabajtami pamięci wygodnie analizuje się zbiory liczone w dziesiątkach, a często w setkach gigabajtów. Na dużej maszynie w chmurze twórcy DuckDB przeliczyli w 2025 roku test TPC-H na 100 terabajtach danych, choć pojedyncze zapytania trwały tam ponad godzinę. W praktyce o szybkości decydują ilość pamięci, liczba rdzeni procesora, szybkość dysku oraz to, czy dane są zapisane w formacie kolumnowym, takim jak Parquet, czy w plikach CSV, które czyta się wolniej.
Tak, DuckDB ma sterowniki ODBC i JDBC, czyli standardowe złącza, przez które łączy się z bazą większość narzędzi do raportowania. Dzięki temu narzędzia do wizualizacji danych mogą odczytywać tabele i widoki z pliku bazy DuckDB tak jak z każdej innej bazy. Dobrze działa też odwrotny kierunek: DuckDB przygotowuje zagregowane dane i zapisuje je do pliku, który narzędzie BI wczytuje. Wybór sposobu zależy od tego, ilu użytkowników korzysta z raportu i jak często dane się zmieniają. Ponieważ do pliku bazy może pisać tylko jeden proces, przy wielu odbiorcach zwykle udostępnia się im dane w trybie tylko do odczytu.
Tak, do pracy z DuckDB wystarczy znajomość podstaw SQL, a od 2025 roku dostępny jest też lokalny interfejs w przeglądarce, który przypomina notatnik z zapytaniami i podglądem wyników. Analityk uruchamia go na swoim komputerze, wskazuje folder z plikami CSV lub Parquet i od razu może filtrować, grupować i porównywać dane, bez instalowania serwera i bez pomocy działu IT. To dobre narzędzie dla osób, które dziś składają raporty z wielu arkuszy. Bez programowania trudniej jednak zautomatyzować regularne odświeżanie danych czy wbudować analizy w aplikację, więc przy stałych raportach dla wielu osób zwykle potrzebny jest programista lub zespół wdrożeniowy.
Koszt wdrożenia DuckDB to przede wszystkim praca zespołu, bo sama baza jest darmowa i zwykle nie wymaga nowego serwera. Najprostszy wariant, czyli przeniesienie jednego wolnego raportu na DuckDB i pliki Parquet, to zazwyczaj praca liczona w dniach lub kilku tygodniach. Większe projekty, na przykład moduł analityczny w aplikacji SaaS z danymi odświeżanymi automatycznie dla każdego klienta osobno, wymagają już zaprojektowania przepływu danych, testów wydajności i monitoringu, co wydłuża prace do kilku miesięcy. Na koszt wpływają liczba źródeł danych, częstotliwość odświeżania, wymagania dotyczące uprawnień i to, czy analizy mają działać w backendzie, w funkcjach chmurowych czy w przeglądarce użytkownika.
SQLite to popularna, lekka baza danych relacyjna, która jest szeroko stosowana w projektach programistycznych na całym świecie. Dzięki swojej prostocie i elastyczności, jest często wykorzystywana jako narzędzie do przechowywania i zarządzania danymi w aplikacjach mobilnych, desktopowych, a także webowych.
Analiza danych to kluczowy element w organizacjach IT. Jednym z najistotniejszych narzędzi umożliwiających efektywne zarządzanie informacjami jest OLAP. Poznanie jego funkcjonowania pozwala na pełniejsze wykorzystanie potencjału danych. W tym artykule demistyfikujemy jego rozwiązania, aby ułatwić jego zrozumienie i implementację.
Transakcje ACID odgrywają kluczową rolę w zapewnianiu integralności i niezawodności baz danych. Aczkolwiek, jak to działa w praktyce? W tym artykule pochylimy się nad koncepcją ACID - zrozumiemy jej fundamentalne zasady i pokażemy, jak przyczynia się ona do efektywnego i bezpiecznego zarządzania danymi w różnych scenariuszach.
ETL, to proces pozyskiwania, transformacji i ładowania danych, który odmienił świat Big Data. Dzisiejsze firmy toną w oceanie informacji wysokojakościowych i nisko strukturyzowanych. Naturalnym wyborem w takim otoczeniu stają się narzędzia ETL, które przyspieszają i usprawniają przetwarzanie danych. W tym artykule poznasz rewolucyjne skutki wprowadzenia ETL do obszaru Big Data.
Jak góry łańcucha danych mogą być pokonane za pomocą Data Lake? W erze eksabajtów, analiza zasobów z dużych zbiorów danych staje się wyzwaniem, które przekracza tradycyjne metody. Data Lake, nowa koncepcja w tej dziedzinie, wychodzi naprzeciw tym problemom, oferując nowe perspektywy.
Szum informacyjny towarzyszący współczesnej gospodarce cyfrowej wymaga nowych metod przechowywania i zarządzania danymi. Jednym z kluczowych rozwiązań jest hurtownia danych, struktura umożliwiająca efektywną analizę, wydobycie oraz integrację zasobów informacyjnych. Artykuł wprowadza w podstawy tego konceptu, podkreślając jego znaczenie i rolę we współczesnym zarządzaniu danymi.