Planowanie produkcji to rozwiązywanie wielowymiarowego problemu optymalizacyjnego pod presją czasu. Planista musi jednocześnie przewidzieć popyt, zarezerwować zdolności produkcyjne, zarządzać zapasami komponentów i reagować na awarie maszyn - często korzystając z arkuszy kalkulacyjnych i doświadczenia zebranego przez lata. Modele machine learning i algorytmy optymalizacyjne nie zastępują tego doświadczenia, ale pozwalają mu działać na danych w skali, której człowiek nigdy nie obsłuży ręcznie.
Planowanie produkcji - co naprawdę optymalizujesz?
Zanim ocenisz, czy AI ma sens w Twoim zakładzie, warto zrozumieć, co dokładnie optymalizujesz. W planowaniu produkcji zazwyczaj chodzi o kilka sprzecznych ze sobą celów jednocześnie: minimalizację kosztów zapasów, maksymalizację wykorzystania maszyn, dotrzymywanie terminów dostaw i minimalizację przestojów. Żadnego z tych celów nie można zoptymalizować osobno - decyzje są ze sobą powiązane. Tradycyjne systemy MRP (Material Requirements Planning) i ich następcy - MRP II i ERP - rozwiązują to zadanie na podstawie sztywnych reguł i parametrów ustawionych raz, a potem ledwo odświeżanych. Kiedy coś idzie nie tak - dostawca się spóźnia, maszyna pada, zamówienie wraca - człowiek ingeruje ręcznie. AI zmienia ten model: zamiast reagować, system zaczyna przewidywać i proponować korektę zanim problem się zmaterializuje.
Warto tu dodać, że AI w produkcji nie oznacza jednego modelu. To najczęściej kilka wyspecjalizowanych komponentów: model prognozy popytu, moduł optymalizacji zapasów, silnik harmonogramowania i warstwa integracyjna z ERP. Każdy z tych komponentów rozwiązuje inne zadanie i może być wdrażany niezależnie.
Prognoza popytu - od arkusza do modelu ML
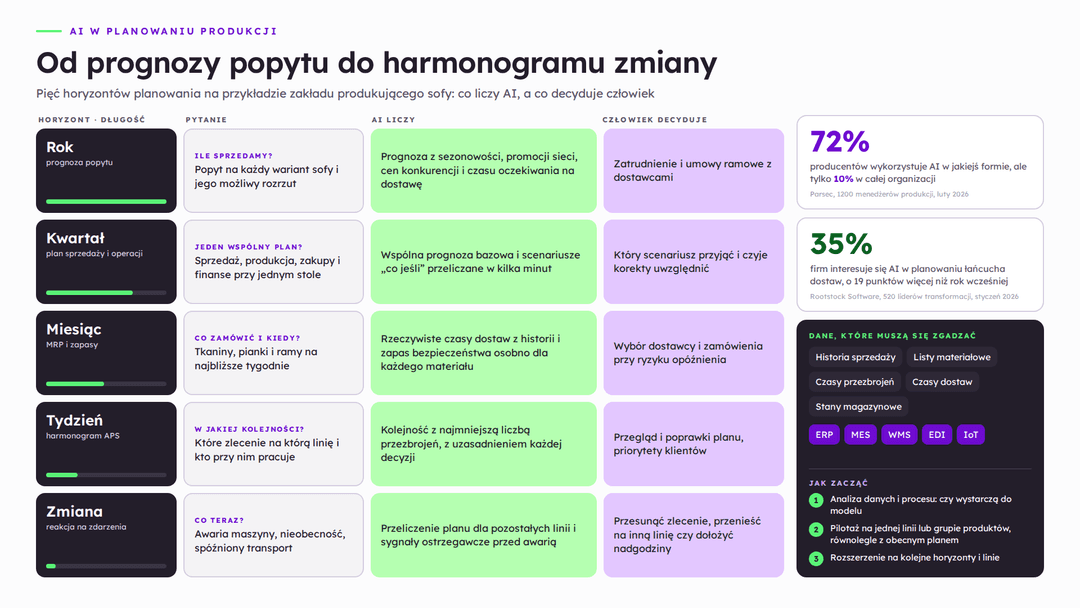
Prognoza popytu to fundament całego łańcucha planowania. Jeśli popyt jest źle oszacowany, cały plan produkcji jest błędny - za dużo lub za mało towaru, zbyt wczesny lub zbyt późny termin uruchomienia linii. Klasyczne metody (średnia krocząca, wygładzanie wykładnicze) działają dobrze przy stabilnym, przewidywalnym popycie. Przy sezonowości, efektach promocji i nagłych zmianach rynkowych zaczynają zawodzić. Modele machine learning, takie jak gradient boosting (XGBoost, LightGBM) czy sieci LSTM, uczą się na historycznych danych sprzedaży z uwzględnieniem zmiennych zewnętrznych: kalendarza świąt, historii kampanii marketingowych, danych o cenach i zmianach asortymentu. Kluczowa różnica w stosunku do klasycznych metod polega na tym, że model sam wykrywa złożone wzorce i potrafi je generalizować na przyszłe okresy.
Ważnym aspektem jest nie tylko trafność prognozy (błąd MAPE lub RMSE), ale też jej przedziały ufności. Planista, który widzi nie tylko wartość centralną, ale też zakres możliwych odchyleń, podejmuje inne decyzje dotyczące zapasów bezpieczeństwa - bardziej adekwatne do faktycznej niepewności niż arbitralne "plus 20%".
Optymalizacja zapasów z modelami predykcyjnymi
Mając prognozę popytu z przedziałami ufności, możesz zoptymalizować poziomy zapasów. Klasyczne wzory na zapas bezpieczeństwa zakładają stały poziom obsługi i normalny rozkład błędów prognozy. W rzeczywistości błędy prognozy rzadko są normalnie rozłożone, a pożądany poziom obsługi zależy od wartości produktu i konsekwencji braku towaru (stockout).
Modele predykcyjne pozwalają ustalać dynamiczne poziomy zapasów bezpieczeństwa: różne dla każdego SKU, dostosowane do sezonowości i aktualnej niepewności prognozy. W połączeniu z modelem ryzyka dostawców - który estymuje prawdopodobieństwo opóźnienia dostawy na podstawie historii - można zoptymalizować cały portfel zapasów, nie tylko poszczególne pozycje w izolacji. Zarządzanie łańcuchem dostaw z szerszej perspektywy - w tym rolę prognozowania w planowaniu zakupów - opisuje artykuł o SCM: zarządzaniu łańcuchem dostaw.
Harmonogramowanie linii: od MRP do algorytmów szeregowania
Harmonogramowanie produkcji (production scheduling) to najtrudniejsza kombinatorycznie część planowania. Problem szeregowania zleceń na wielu maszynach należy do klasy NP-trudnych - nie istnieje algorytm, który znajdzie optymalne rozwiązanie w rozsądnym czasie dla realnych danych przemysłowych. W praktyce stosuje się heurystyki i metaheurystyki. Klasyczne reguły priorytetyzacji (SPT - najkrótszy czas przetwarzania, EDD - najwcześniejszy termin dostawy, CR - critical ratio) są szybkie, ale dają suboptymalne wyniki przy złożonych zależnościach między zleceniami. Metaheurystyki - algorytmy genetyczne, symulowane wyżarzanie, optymalizacja rojem cząstek - szukają lepszych rozwiązań kosztem czasu obliczeniowego.
W ostatnich latach coraz większą rolę odgrywa uczenie ze wzmocnieniem (reinforcement learning), w którym agent "uczy się" dobrej polityki szeregowania przez tysiące symulowanych przebiegów na modelu fabryki. Efekt: system w czasie rzeczywistym reaguje na awarie maszyn, pilne zlecenia czy zmiany w dostępności materiałów, przeliczając harmonogram w ciągu sekund, nie godzin.
Integracja AI z systemem ERP
Modele AI nie działają w oderwaniu od systemu ERP - muszą z nim wymieniać dane w obu kierunkach. W typowej architekturze model prognozy popytu pobiera dane historyczne z ERP (sprzedaż, zwroty, promocje, korekty), generuje prognozę i odsyła ją do modułu planowania jako wejście do MRP. Silnik harmonogramowania odbiera zlecenia produkcyjne z ERP i zwraca gotowy harmonogram ze wskazaniem czasu i zasobu dla każdego zlecenia. Kluczowe wyzwania integracyjne to: jakość danych w ERP (błędy w kodach SKU, zduplikowane dokumenty, opóźnione korekty), latencja (planowanie online reagujące na awarie w ciągu minut wymaga innej architektury niż przetwarzanie wsadowe nocne) oraz wyjaśnialność - planiści muszą rozumieć, dlaczego model proponuje konkretny harmonogram. Modele bez wyjaśnień napotkają opór użytkowników.
Pełen obraz możliwości analityki danych w przemyśle znajdziesz w artykule o Business Intelligence i narzędziach do analizy BI.
Wdrożenie w praktyce: dane, architektura, czas
Wdrożenie AI w planowaniu produkcji zaczyna się od audytu danych, nie od wyboru algorytmu. Minimalny zakres historycznych danych, który pozwala trenować użyteczny model prognozy, to zwykle 2-3 lata na poziomie SKU - z uwzględnieniem sezonowości i wszelkich anomalii w tym czasie. Typowy stos technologiczny dla serwisu predykcyjnego: Python jako środowisko modelowania (scikit-learn, LightGBM), PostgreSQL lub hurtownia danych jako warstwa persystencji, Docker do konteneryzacji serwisów wnioskowania i kolejka komunikatów (RabbitMQ) do asynchronicznej wymiany danych z ERP. Model jest retrenowany cyklicznie (np. co tydzień) na świeżych danych.
Czas wdrożenia pilotu (proof of concept dla jednej linii produktowej) to zwykle 8-16 tygodni. Pełne wdrożenie obejmujące cały zakład i głęboka integracja z ERP trwa 6-18 miesięcy, zależnie od jakości danych i złożoności procesów. Opis mechanizmów uczenia maszynowego stosowanych w prognozie znajdziesz w artykule AI Regression: jak maszyny uczą się z przeszłości.
Kiedy AI w planowaniu produkcji się opłaca - i kiedy nie
AI przynosi największą wartość przy wysokiej zmienności popytu, dużej liczbie SKU, złożonej sieci zależności między komponentami i produktami oraz gdy koszty nadmiarowych zapasów lub przestojów produkcyjnych są wysokie. Im bardziej chaos w planowaniu kosztuje, tym większy zwrot z inwestycji w modele predykcyjne.
Kiedy AI może nie być właściwym krokiem: bardzo stabilny popyt z jednym lub kilkoma SKU (klasyczne metody wystarczą), brak historycznych danych w ERP lub ich zła jakość, organizacja bez jeszcze zintegrowanego systemu ERP (wtedy najpierw ERP), lub zakład, w którym głównym wąskim gardłem są procesy zarządcze i operacyjne, nie obliczeniowe.
Szczegółowy przegląd możliwości AI w logistyce - od routingu po predykcję popytu w całym łańcuchu dostaw - znajdziesz w artykule AI w logistyce: automatyzacja dostaw, routing i predykcja popytu.