

Mniej porzuconych wniosków dzięki prostszej ścieżce do finansowania
Klient: Horyzont Capital
Branża: Finanse / FinTech
AI w finansach coraz częściej podejmuje pierwszą decyzję zamiast człowieka - w ocenie zdolności kredytowej, wykrywaniu oszustw czy kwalifikacji wniosków. Wyjaśniamy, jak działają takie systemy, z jakich danych korzystają i gdzie leżą realne trudności wdrożenia.

CEO
23 wrz 2026
AI w finansach przestała być wyłącznie narzędziem do analizy danych po fakcie. Coraz częściej podejmuje pierwszą decyzję - czy przyznać kredyt, czy transakcja wygląda podejrzanie, czy wniosek klienta kwalifikuje się do dalszego rozpatrzenia. Człowiek wciąż nadzoruje proces, ale to model ocenia sprawę w ułamku sekundy, zanim ktokolwiek na nią spojrzy. Dla banku, funduszu czy firmy pożyczkowej oznacza to konkretną zmianę operacyjną. Wniosek, który kiedyś czekał w kolejce do analityka, dziś dostaje wstępną ocenę natychmiast. Zespół zajmuje się wyjątkami i przypadkami granicznymi, a nie każdym wnioskiem z osobna. To przesuwa pracę ludzi z rutyny w stronę decyzji, które faktycznie wymagają doświadczenia.
Warto od razu rozdzielić dwa poziomy automatyzacji, bo w rozmowach często się je myli. Pierwszy to wsparcie decyzji - model wylicza wynik, ryzyko albo rekomendację, ale ostatnie słowo zawsze należy do człowieka. Drugi to decyzja w pełni automatyczna - system sam akceptuje albo odrzuca wniosek, bez udziału analityka, w ramach z góry ustalonych zasad.
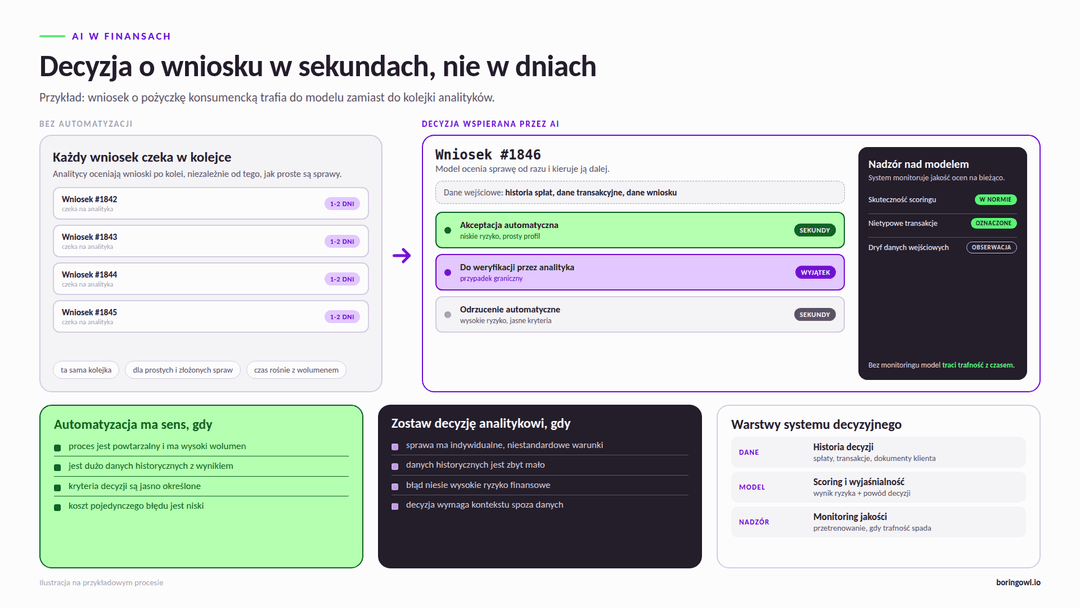
W praktyce większość instytucji zaczyna od pierwszego poziomu i przesuwa się w stronę drugiego stopniowo, tam gdzie ryzyko błędu jest niskie, a wolumen wysoki. Mała pożyczka konsumencka o ustandaryzowanym profilu klienta nadaje się do pełnej automatyzacji szybciej niż duży kredyt korporacyjny z indywidualnymi warunkami. Ten drugi zwykle zostaje przy modelu wspierającym, gdzie AI przygotowuje analizę, a decyzję podejmuje komitet kredytowy. Granicę między tymi poziomami wyznacza nie tyle sama technologia, ile apetyt na ryzyko danej instytucji i jakość danych, na których model się uczy. Im więcej historycznych przypadków z jasnym wynikiem - spłacono albo nie, transakcja była oszustwem albo nie - tym łatwiej zaufać modelowi w pełni automatycznej decyzji.
Sposób, w jaki organizacja w ogóle dochodzi do takich ustaleń, to już osobne zagadnienie, które szerzej opisaliśmy przy okazji procesu decyzyjnego w IT - tam, gdzie decyzja dotyczy wyboru technologii, mechanizm ustalania odpowiedzialności jest bardzo podobny do tego przy wdrażaniu automatyzacji.
Najbardziej dojrzałe zastosowanie AI w finansach to ocena zdolności kredytowej. Zamiast pojedynczego wskaźnika liczonego raz na wejściu, nowoczesny scoring łączy dane z wielu źródeł - historię spłat, dane transakcyjne z konta, czasem też dane behawioralne, jak sposób wypełniania formularza. Model korzysta z technik uczenia maszynowego i uczy się na tysiącach wcześniejszych decyzji, szukając wzorców, które trudno zauważyć w tradycyjnej tabeli punktowej. Mechanizm dobrze opisuje drzewo decyzyjne - jedna z prostszych, ale wciąż używanych metod uczenia maszynowego, w której model dzieli dane na kolejne kryteria, aż dojdzie do konkretnej rekomendacji. W praktyce banki rzadko opierają się już na jednym takim modelu, tylko łączą wyniki kilku podejść, od prostych drzew po bardziej złożone sieci, i biorą pod uwagę ich zgodność.
Efekt dla klienta jest wymierny. Wniosek o pożyczkę, który kiedyś czekał dzień lub dwa na analityka, dziś dostaje wstępną decyzję w kilka sekund. Nie oznacza to, że każdy wniosek jest akceptowany automatycznie - przypadki graniczne i tak trafiają do człowieka, ale liczba takich przypadków jest znacznie mniejsza niż przy w pełni ręcznej analizie.
Drugie, obok scoringu, najczęstsze zastosowanie to fraud detection - wykrywanie transakcji, które odbiegają od typowego zachowania klienta. Model uczy się profilu każdego konta: ile zwykle wydaje, gdzie, o jakiej porze, jakimi kanałami. Transakcja, która nie pasuje do tego wzorca, dostaje wyższy wynik ryzyka i trafia do dodatkowej weryfikacji, zanim zostanie zatwierdzona. Różnica względem starszych systemów reguł biznesowych - takich jak „zablokuj transakcję powyżej pięciu tysięcy złotych za granicą" - jest zasadnicza. Reguła jest sztywna i łatwa do obejścia, gdy oszust ją pozna. Model uczący się na bieżąco dostosowuje się do nowych wzorców oszustw, choć wymaga to stałego dostarczania świeżych danych i regularnego przetrenowania.
Podobną logikę, tylko w innym sektorze, opisaliśmy przy okazji AI w ubezpieczeniach, gdzie modele oceniają zgłoszenia szkód pod kątem prawdopodobieństwa nadużycia. Mechanizm jest zbliżony - w obu przypadkach chodzi o odróżnienie normalnego zachowania od odchylenia, które zasługuje na uwagę człowieka.
Zanim wniosek trafi do oceny ryzyka, ktoś - albo coś - musi sprawdzić, czy jest w ogóle kompletny i poprawny. To zadanie, które dobrze nadaje się do automatyzacji, bo jest powtarzalne i ma jasne kryteria: brakujący dokument, niezgodność danych, przekroczony limit wieku. Duże modele językowe potrafią czytać dokumenty przesłane przez klienta, wyciągać z nich potrzebne dane i sprawdzać ich spójność ze złożonym wnioskiem, zamiast angażować do tego pracownika na każdym etapie. Dopiero wniosek, który przeszedł tę wstępną kwalifikację, trafia do właściwej oceny ryzyka. Takie podejście dobrze wpisuje się w architekturę opartą na LangChain, frameworku łączącym modele językowe z zewnętrznymi źródłami danych i dokumentami klienta.
Wstępna kwalifikacja nie kończy się na dokumentach. Coraz częściej obejmuje też pierwszy kontakt z klientem - chatbot albo voicebot zbiera podstawowe informacje o potrzebie finansowej, zanim sprawa trafi do konsultanta, który zajmuje się już tylko przypadkami wymagającymi rozmowy.
Warto odróżnić to od prostszej zrobotyzowanej automatyzacji procesów, która przepisuje dane między systemami według sztywnych reguł, bez podejmowania jakiejkolwiek oceny. Oba podejścia często działają obok siebie - RPA odciąża pracowników od czynności mechanicznych, a modele AI zajmują się tym, co wymaga faktycznej oceny sytuacji.
Klient: Horyzont Capital
Branża: Finanse / FinTech
Poza decyzjami dotyczącymi pojedynczego klienta, AI w finansach wspiera też decyzje na poziomie całej instytucji - ocenę ryzyka portfela kredytowego, prognozowanie strat czy wykrywanie sygnałów ostrzegawczych w danych operacyjnych. To obszar bliższy analityce niż automatyzacji pojedynczej transakcji, ale oparty na tych samych fundamentach: dobrej jakości danych i modelach, które regularnie się weryfikuje.
Szerszy kontekst tego tematu opisujemy w artykule o ryzyku operacyjnym - zagrożeniach wynikających z błędów systemów, procesów albo ludzi, które w instytucji finansowej mają bezpośrednie przełożenie na wynik finansowy. Modele predykcyjne pomagają wychwycić takie sygnały wcześniej, zanim urosną do skali realnego problemu.
Zbudowanie systemu, który automatyzuje decyzje finansowe, zaczyna się od danych - ich zebrania, oczyszczenia i połączenia w jeden spójny obraz klienta czy transakcji. Dane pochodzą zwykle z kilku miejsc naraz: systemu bankowego, historii transakcji, czasem zewnętrznych baz, do których instytucja ma dostęp. Zanim trafią do modelu, muszą przejść przez warstwę normalizacji, która ujednolica formaty i usuwa błędy.
Sam model to zwykle najmniejsza część projektu, choć najbardziej widoczna. Ważniejsze jest to, co dzieje się wokół niego - monitoring jakości predykcji, wersjonowanie modeli i możliwość prześledzenia, dlaczego konkretna decyzja wypadła tak, a nie inaczej. W finansach wyjaśnialność decyzji ma znaczenie praktyczne, nie tylko formalne: analityk, który dostaje odrzucenie wniosku bez powodu, nie potrafi ocenić, czy model się myli.
Do przechowywania i przeszukiwania dużych zbiorów danych, na przykład historycznych opisów transakcji czy dokumentów klientów, dobrze sprawdzają się bazy wektorowe, takie jak Qdrant - pozwalają szybko znaleźć podobne przypadki z przeszłości i wykorzystać je jako kontekst dla modelu podejmującego bieżącą decyzję.
Same modele językowe, na przykład rodziny Anthropic, coraz częściej wchodzą do tego stosu jako warstwa łącząca dane nieustrukturyzowane - dokumenty, opisy, korespondencję - z resztą systemu.
Integracja z systemami źródłowymi to zwykle najbardziej czasochłonna część projektu, bo instytucje finansowe rzadko mają jeden spójny system - częściej kilka, dokładanych przez lata. Dobrze zaprojektowana architektura SaaS ułatwia to spięcie, ale rzadko eliminuje potrzebę pisania dedykowanych łączników pod konkretne systemy legacy.
Tam, gdzie automatyzacja obejmuje też wewnętrzne procesy operacyjne instytucji, na przykład rozliczenia czy raportowanie, dobrze sprawdza się dedykowany system klasy ERP, który staje się jednym źródłem prawdy dla danych zasilających model.
Największym problemem rzadko okazuje się sam model. Jest nim jakość i dostępność danych historycznych, na których w ogóle da się go nauczyć. Instytucja, która przez lata podejmowała decyzje ręcznie i nie zapisywała uzasadnień, ma niewiele materiału do trenowania modelu - musi zacząć od zbierania danych, zanim automatyzacja stanie się możliwa.
Drugim wyzwaniem jest utrzymanie modelu w czasie. Zachowania klientów i wzorce oszustw zmieniają się, więc model wytrenowany rok temu może dziś podejmować gorsze decyzje niż na starcie. Wymaga to stałego monitoringu jakości predykcji i procesu, który sygnalizuje spadek skuteczności, zanim zauważą go klienci albo audyt wewnętrzny.
Trzecim, częściej pomijanym problemem jest bezpieczeństwo samych systemów decyzyjnych. Model, który automatycznie akceptuje wnioski kredytowe, jest atrakcyjnym celem - błąd w jego zabezpieczeniach może kosztować więcej niż błąd w samej ocenie ryzyka. Dlatego projekty tego typu warto od początku prowadzić razem z audytem bezpieczeństwa aplikacji, podobnym do tych opisanych przy okazji naszych usług bezpieczeństwa.
Pełna automatyzacja wszystkich decyzji naraz to zły punkt startowy. Lepiej wybrać jeden proces o wysokim wolumenie i stosunkowo niskim ryzyku pojedynczej decyzji - na przykład wstępną kwalifikację prostych wniosków - i zbudować dla niego działający system, zanim rozszerzy się zakres na bardziej złożone decyzje.
Warto zacząć od warsztatu, który precyzuje, które decyzje w ogóle nadają się do automatyzacji, a które lepiej zostawić człowiekowi - to zadanie zbliżone do tego, czym zajmujemy się w ramach product discovery. Dopiero na tej podstawie da się sensownie zaplanować architekturę danych i wybrać, które elementy budować od zera, a które oprzeć na gotowych komponentach.
Taki projekt rzadko kończy się na jednym wdrożeniu. Model wymaga utrzymania, dane rosną, a zakres automatyzacji zwykle się poszerza wraz z zaufaniem do systemu - to jeden z powodów, dla których traktujemy go jako część szerszej transformacji cyfrowej instytucji, a nie pojedynczy projekt technologiczny.
Jeśli Twoja instytucja rozważa automatyzację któregoś z procesów decyzyjnych, opisz nam ten projekt przez formularz kontaktowy Boring Owl.
FAQ
Blog
Wycena ryzyka i szkody, wykrywanie wyłudzeń, obsługa zgłoszeń od pierwszego kontaktu do wypłaty. Gdzie AI w ubezpieczeniach daje mierzalny efekt, co pozwalają zautomatyzować przepisy i kiedy lepiej zostać przy regułach i doświadczonym likwidatorze.
Drzewo decyzyjne, jest potężnym narzędziem służącym do optymalizacji procesów decyzyjnych. Umożliwia analizę różnorodnych scenariuszy, identyfikację optymalnych ścieżek decyzyjnych, a także kwantyfikację ryzyka. Wyszukuje złożone zależności, które mogą nie być oczywiste na pierwszy rzut oka. Jego praktyczne zastosowania są niezwykle szerokie i obejmują min. zarządzanie projektami, medycynę, naukę dat, a także AI.
W świecie AI, duże modele językowe (LLM) stają się kluczowym elementem ewolucji. Pozwalają maszynom na naturalne 'rozumienie' i generowanie języka ludzkiego. Na czym jednak polega ich działanie? Jak wpłynęły na przełom w sztucznej inteligencji? Sprawdźmy to!
Machine learning, to dziedzina informatyki skupiająca się na tworzeniu systemów, które potrafią uczyć się i dostosowywać do dostarczanych im danych. Jest to technologia bardzo ważna w dzisiejszym świecie, ponieważ pozwala na automatyzację procesów i zwiększenie efektywności w wielu dziedzinach, takich jak rozpoznawanie obrazów, analiza tekstu czy prognozowanie pogody.
Większość robo-advisorów działa na prostych regułach, a sztuczna inteligencja zmienia głównie to, co dzieje się wokół portfela: ocenę klienta, rozmowę o wynikach i pracę doradcy. Pokazujemy, gdzie AI realnie pomaga, czego oczekują KNF, ESMA i AI Act oraz kiedy własny robo-advisor się nie zepnie.
Ryzyko operacyjne to zagrożenia wynikające z błędów, awarii lub nieprawidłowych działań systemów, najczęściej związane z technologiami informatycznymi. Celem każdej organizacji jest minimalizacja takich ryzyk, ale jak je właściwie określić? W tym artykule opiszemy poszczególne kroki tego procesu.