
Mniej porzuconych wniosków dzięki prostszej ścieżce do finansowania
Klient: Horyzont Capital
Branża: Finanse / FinTech
Wycena ryzyka i szkody, wykrywanie wyłudzeń, obsługa zgłoszeń od pierwszego kontaktu do wypłaty. Gdzie AI w ubezpieczeniach daje mierzalny efekt, co pozwalają zautomatyzować przepisy i kiedy lepiej zostać przy regułach i doświadczonym likwidatorze.

CEO
16 sie 2026
Poniedziałek, wpół do dziewiątej. W systemie czeka kilkaset zgłoszeń z weekendu: stłuczki na parkingach, zalane łazienki, zbite szyby, dwa pobyty w szpitalu. Większość jest prosta i uczciwa, a mimo to każda przechodzi tę samą ścieżkę. Likwidator otwiera załączniki, przepisuje dane do systemu, ogląda zdjęcia, prosi o brakujące dokumenty. Gdzieś w tym stosie leży szkoda ze zdjęciem, które pół roku temu dołączono już do innego zgłoszenia. Nikt tego nie zauważy, bo nikt nie ma czasu porównywać. Właśnie w takim poniedziałku najlepiej widać, do czego AI w ubezpieczeniach przydaje się naprawdę.
Tytułowe obszary mają ze sobą więcej wspólnego, niż sugerują nazwy działów. Automatyczna wycena (składki albo szkody) to przewidywanie kwoty na podstawie danych. Wykrywanie nadużyć to szukanie przypadków, które odstają od wzorca. Obsługa szkód to w dużej mierze czytanie dokumentów i podejmowanie powtarzalnych decyzji. W każdym z tych obszarów model może przejąć część pracy. W żadnym nie powinien działać bez nadzoru.
Poniżej opisujemy, jak to wygląda od strony wdrożenia: jakie dane są potrzebne, co wolno zautomatyzować w świetle polskich i unijnych przepisów, gdzie modele się mylą i kiedy lepiej zostać przy regułach oraz doświadczonym likwidatorze. Piszemy z perspektywy zespołu, który tworzy oprogramowanie dla firm ubezpieczeniowych i łączy je z systemami, które te firmy już mają.
Najprostsze wyjaśnienie leży w liczbach. Według raportu Polskiej Izby Ubezpieczeń z lipca 2026 r. ubezpieczyciele ujawnili w 2025 r. przestępstwa o łącznej wartości blisko 800 mln zł, o 18% więcej niż rok wcześniej (675 mln zł). W ubezpieczeniach majątkowych około 64% wykrytych przypadków dotyczyło komunikacji: upozorowanych kolizji, celowo spowodowanych wypadków, fikcyjnych obrażeń i pozorowanych kradzieży aut. A to tylko to, co wyszło na jaw. Insurance Europe szacuje, że wykryte i niewykryte oszustwa razem odpowiadają za około 10% wszystkich wydatków na odszkodowania w Europie. Zmieniła się też technika samych wyłudzeń. Ten sam raport PIU wskazuje, że sprawcy masowo używają ogólnodostępnych narzędzi AI do preparowania dokumentacji medycznej. Fałszywa karta informacyjna ze szpitala albo faktura za naprawę powstaje w kilka minut i wygląda poprawnie. Kontrola oparta na tym, że likwidator „zauważy coś dziwnego", przestaje wystarczać, gdy podróbka nie ma literówek ani krzywych pieczątek.
Po drugiej stronie jest klient, który czeka na pieniądze. Art. 817 Kodeksu cywilnego daje ubezpieczycielowi 30 dni od otrzymania zawiadomienia o wypadku, a gdy okoliczności wymagają wyjaśnienia, 14 dni od momentu, w którym przy należytej staranności dało się je wyjaśnić. Bezsporną część świadczenia trzeba wypłacić w pierwszym terminie. Klient nie porównuje jednak obsługi z kodeksem. Porównuje ją z bankiem, w którym przelew idzie w kilka sekund.
Branża już reaguje. W badaniu EIOPA, europejskiego nadzoru ubezpieczeniowego, przeprowadzonym na 209 zakładach z 22 państw i opublikowanym w 2024 r., 50% ubezpieczycieli majątkowych i 24% ubezpieczycieli na życie deklarowało korzystanie z AI. Kolejne 30% i 39% planowało wdrożenie w ciągu trzech lat. Najczęściej wskazywane zastosowania to obsługa klienta, wykrywanie nadużyć, likwidacja szkód, sprzedaż i wycena. Dane mają jedno zastrzeżenie: opisują stan z 2022 r., sprzed upowszechnienia modeli generatywnych.
Klient: Horyzont Capital
Branża: Finanse / FinTech
Klient: Jabłoński & Wspólnicy
Branża: Prawo / LegalTech
Słowo „wycena" oznacza w ubezpieczeniach dwie różne rzeczy. Pierwsza to wycena ryzyka, czyli ustalenie składki przy zawieraniu umowy. Druga to wycena szkody, czyli ustalenie, ile należy się poszkodowanemu. Obie da się wspierać modelami, ale każda wymaga innych danych i niesie inne ryzyko błędu.
Taryfa to zwykle model statystyczny zbudowany przez aktuariuszy, najczęściej uogólniony model liniowy (GLM). To klasyczna metoda, w której każdy czynnik, na przykład wiek pojazdu czy kod pocztowy, ma jawną i sprawdzalną wagę. Uczenie maszynowe nie zastępuje tej taryfy, tylko ją uzupełnia. Modele zespołowe, czyli łączące wyniki wielu prostych drzew decyzyjnych, takie jak gradient boosting, same wyłapują zależności, których w GLM nikt z góry nie zapisał. Młody kierowca w dużym mieście powoduje inne szkody niż młody kierowca na wsi, a sama zmienna „wiek" tego nie pokaże. W praktyce model uczenia maszynowego najczęściej podpowiada aktuariuszom, w których segmentach taryfa się myli, zamiast samodzielnie liczyć składkę. Powód jest prosty. Taryfę trzeba umieć uzasadnić przed nadzorem i klientem, a „tak wyszło z modelu" uzasadnieniem nie jest.
Większy efekt niż wymiana algorytmu dają często nowe źródła danych. Przy ubezpieczeniach nieruchomości to dane o lokalizacji, na przykład odległość od rzeki i historia podtopień w okolicy. Podobnie działają automatyczne modele wyceny nieruchomości, z których korzysta rynek kredytów hipotecznych. W ubezpieczeniach komunikacyjnych takim źródłem jest telematyka, czyli dane o stylu jazdy z aplikacji albo urządzenia w aucie. Każde nowe źródło rodzi jednak pytanie o zgodę klienta i o to, czy dane wolno wykorzystać w automatycznej decyzji. Wracamy do tego w części o przepisach.
W szkodach komunikacyjnych pierwszym „rzeczoznawcą" coraz częściej jest aplikacja. Klient fotografuje auto według wskazówek na ekranie, a rozpoznawanie obrazu przez AI wskazuje uszkodzone elementy i proponuje zakres prac, od lakierowania po wymianę części. Na tej podstawie system kosztorysowy wylicza kwotę. Dla typowych uszkodzeń blacharskich w popularnych modelach aut to działa dobrze. Gorzej ze szkodami, których nie widać na zdjęciu, jak pęknięty wspornik za zderzakiem czy uszkodzony czujnik radaru. Rozsądnie ustawiony proces traktuje więc wycenę ze zdjęć jako propozycję. Klient może ją przyjąć od ręki, a przy wyższej kwocie albo niskiej pewności modelu sprawa trafia na oględziny. Zalanie mieszkania czy pożar to inna sytuacja, bo zdjęcia mówią tu mniej. Więcej daje odczytanie faktur i kosztorysów wykonawców, a potem porównanie cen z historią podobnych szkód w tym samym regionie. Model ocenia wtedy przede wszystkim wiarygodność kwot.
Wykrywanie nadużyć, po angielsku fraud detection, nie polega na tym, że model „wie", kto kłamie. Polega na nadaniu każdej szkodzie oceny ryzyka i skierowaniu najbardziej podejrzanych do specjalistów. To klasyczne zadanie analizy predykcyjnej. Decyzja o odmowie wypłaty z powodu podejrzenia oszustwa powinna należeć do człowieka, który zna materiał dowodowy.
Większość towarzystw ma już system reguł, tak zwanych red flags. Szkoda zgłoszona kilka dni po zawarciu polisy, kolizja w nocy bez świadków, suma ubezpieczenia podniesiona tuż przed pożarem, zgłaszający, który nie pamięta szczegółów zdarzenia, ale świetnie zna warunki polisy. Reguły są przejrzyste i łatwo je wyjaśnić. Mają za to dwie wady: generują dużo alarmów i szybko stają się znane. Kto raz dostał odmowę, wie, czego unikać następnym razem. Model uczenia maszynowego patrzy na setki cech jednocześnie i ocenia ich kombinację. Uczy się na historycznych szkodach, które kiedyś potwierdzono jako wyłudzenia. Tu leży pierwsza pułapka. Takich przypadków jest mało, a te, które są, pokazują głównie schematy, które zespół już umiał wykrywać. Dlatego obok modeli uczonych na przykładach stosuje się wykrywanie anomalii, czyli szukanie szkód nietypowych na tle reszty portfela, bez gotowej etykiety „oszustwo".
Zorganizowane grupy najczęściej wychodzą na jaw w analizie powiązań. Ten sam numer telefonu przy pięciu szkodach. Ten sam warsztat przy kolizjach tych samych kierowców. Świadek jednej stłuczki jako sprawca drugiej. Pojedyncza szkoda nie budzi podejrzeń, cała sieć już tak. Technicznie to graf, w którym węzłami są osoby, pojazdy, adresy i warsztaty, a połączeniami wspólne szkody. Takie zależności widać dopiero wtedy, gdy dane z systemu polisowego i szkodowego trafiają w jedno miejsce.
AI działa tu po obu stronach. Sprawcy generują dokumenty i przerabiają zdjęcia, ubezpieczyciel używa podobnych technik do ich wychwytywania. Sporo dają proste testy: czy to samo lub bardzo podobne zdjęcie nie pojawiło się już w innej szkodzie i czy metadane pliku, na przykład data wykonania i współrzędne, zgadzają się z opisem zdarzenia. Dokumenty porównuje się z wzorami, które dana placówka medyczna albo warsztat wystawiały wcześniej. Wykrywanie treści w całości wygenerowanych przez AI jest trudniejsze. To wyścig, w którym detektor zwykle zostaje o krok za generatorem, podobnie jak przy obrazach i nagraniach typu deepfake. Skuteczniejsza bywa weryfikacja u źródła: zapytanie do szpitala, czy wystawił dany dokument, albo porównanie danych z rejestrami, do których ubezpieczyciel ma dostęp.
Każda szkoda oznaczona jako podejrzana kosztuje. Czas specjalisty i nerwy klienta, który najczęściej okazuje się uczciwy, a na pieniądze czeka dłużej. Model, który wykrywa więcej oszustw kosztem podwojenia liczby alarmów, może w praktyce pogorszyć wynik, bo zespół dochodzeniowy nie przerobi kolejki. Próg alarmu ustawia się więc pod przepustowość zespołu i wartość szkód. Abstrakcyjna „skuteczność" modelu niewiele tu mówi. Najprostszy wskaźnik do śledzenia to odsetek alarmów, które kończą się faktycznym ujawnieniem nadużycia. Gdy spada, model albo reguły wymagają przeglądu.
Likwidacja szkody, czyli cały proces od zgłoszenia do wypłaty, to w dużej części praca z dokumentami i rozmowy z klientem. Tu AI zwraca się najszybciej, bo efekt widać od razu w czasie obsługi.
Zgłoszenia bywają chaotyczne. Klient pisze maila bez numeru polisy, a zdjęcia wysyła w trzech osobnych wiadomościach. Chatbot przyjmujący zgłoszenia szkód dopytuje o brakujące dane, sprawdza polisę, rozpoznaje rodzaj szkody i od razu mówi, jakich dokumentów będzie potrzeba. Gdy sprawa wykracza poza jego zakres, przekazuje rozmowę konsultantowi razem z tym, co już ustalił. Część klientów woli zadzwonić, zwłaszcza tuż po wypadku. Przy dużym ruchu na infolinii tę samą pracę wykonują voiceboty, które przyjmują podstawowe informacje i zakładają zgłoszenie. Rozmowę z osobą w szoku albo po poważnym wypadku lepiej jednak od razu przełączać do człowieka.
Faktury, kosztorysy, karty informacyjne ze szpitala, notatki policyjne, oświadczenia sprawców. Klasyczny OCR, czyli zamiana skanu na tekst, to dopiero początek. Model językowy, czyli ten sam rodzaj AI, na którym działają czaty w rodzaju ChatGPT, rozumie, co jest czym. Wie, że kwota na dole faktury to wartość brutto, że rozpoznanie w karcie szpitalnej zapisano kodem ICD-10, że data na pieczątce różni się od daty zdarzenia i że w oświadczeniu sprawca przyznaje się do winy. Z tego powstają uporządkowane dane, które trafiają prosto do systemu szkodowego.
Dokumentacja medyczna to dane szczególnej kategorii w rozumieniu RODO, czyli między innymi informacje o zdrowiu. O wyborze modelu i miejsca przetwarzania decyduje wtedy w równym stopniu prawnik, co architekt systemu. Samą aplikację, przez którą przechodzą takie dane, dobrze jest przed startem poddać audytowi bezpieczeństwa aplikacji.
Część szkód w ogóle nie potrzebuje likwidatora. Zbita szyba albo zwrot kosztów wizyty lekarskiej w ramach limitu polisy to dobre przykłady. Gdy kwota jest niska, warunki jasne, dokumenty kompletne, a ocena ryzyka nadużycia niska, system może przygotować decyzję i wypłatę bez udziału człowieka. Taki podział spraw, nazywany triażem, sprawia, że likwidatorzy zajmują się szkodami, w których ich doświadczenie ma znaczenie. Próg automatycznej wypłaty dobrze jest ustawić nisko na starcie. Podnosi się go wtedy, gdy dane z kilku miesięcy pokażą, że decyzje automatu nie odbiegają od ludzkich.
Ogólne warunki ubezpieczenia potrafią mieć kilkadziesiąt stron, a w portfelu działa kilkanaście ich wersji. Asystent zbudowany w technice RAG, czyli model językowy odpowiadający na podstawie wskazanych dokumentów, a nie własnej pamięci, odnajduje właściwy zapis i pokazuje paragraf, z którego pochodzi. Likwidator nadal decyduje. Nie traci tylko pół godziny na szukanie wyłączenia odpowiedzialności.
Ten sam asystent pomaga pisać uzasadnienia decyzji i odpowiedzi na reklamacje. Pod jednym warunkiem: każdy tekst, który trafia do klienta, czyta i zatwierdza człowiek. Modele językowe brzmią pewnie także wtedy, gdy się mylą.
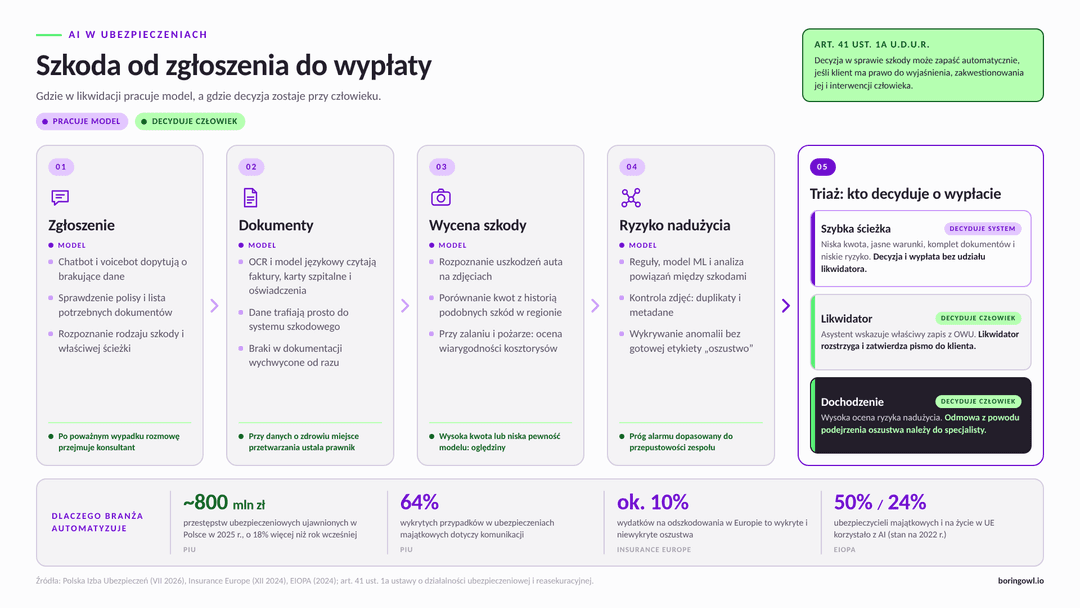
Punktem wyjścia jest art. 22 RODO. Daje on każdemu prawo, by nie podlegać decyzji opartej wyłącznie na zautomatyzowanym przetwarzaniu, jeśli wywołuje ona wobec niego skutki prawne lub w podobny sposób istotnie na niego wpływa. Polski ustawodawca przewidział dla ubezpieczeń osobną podstawę. Art. 41 ust. 1a ustawy o działalności ubezpieczeniowej i reasekuracyjnej pozwala zakładowi ubezpieczeń podejmować takie decyzje przy ocenie ryzyka ubezpieczeniowego, a także przy ustalaniu przyczyn zdarzeń i wysokości szkód. Warunek: klient ma prawo do wyjaśnienia podstaw decyzji, do jej zakwestionowania, przedstawienia własnego stanowiska i interwencji człowieka.
Z tego wynikają konkretne wymagania dla systemu. Model musi zostawiać ślad, na podstawie jakich danych i czynników podjął decyzję, bo bez tego nie da się jej wyjaśnić. Proces musi mieć ścieżkę odwołania do człowieka. Do zautomatyzowanych decyzji wolno też używać wyłącznie kategorii danych wymienionych w ust. 1b tego artykułu, więc podejście „wrzućmy do modelu wszystko, co mamy" odpada.
AI Act, unijne rozporządzenie o sztucznej inteligencji, zalicza do systemów wysokiego ryzyka te, które służą do oceny ryzyka i ustalania cen w ubezpieczeniach na życie i zdrowotnych osób fizycznych (załącznik III pkt 5 lit. c). Ubezpieczeń komunikacyjnych i majątkowych ani wykrywania nadużyć na tej liście nie ma. Termin stosowania obowiązków dla systemów z załącznika III przesunęło rozporządzenie (UE) 2026/1744, tak zwany Digital Omnibus, które weszło w życie 27 lipca 2026 r. Zamiast od sierpnia 2026 r. obowiązują one od 2 grudnia 2027 r. Chodzi między innymi o system zarządzania ryzykiem, dokumentację techniczną, rejestrowanie zdarzeń i nadzór człowieka.
To, że system nie trafił do kategorii wysokiego ryzyka, nie zwalnia z odpowiedzialności. EIOPA w opinii z sierpnia 2025 r. opisała, czego nadzór oczekuje przy pozostałych zastosowaniach AI w ubezpieczeniach: udokumentowanego zarządzania danymi, sprawdzania, czy wyniki nie są dyskryminujące, wyjaśnialności i realnego nadzoru człowieka.
Nie każdy problem w dziale szkód jest problemem dla modelu. Wdrożenie zwykle się nie broni w pięciu sytuacjach:
Zdarza się też sytuacja odwrotna. Reguły działają dobrze, a firma chce „dodać AI", bo robi to konkurencja. Wtedy najuczciwszą rekomendacją bywa dopracowanie reguł i raportowania. Mniej efektowne. Za to tańsze.
FAQ
Blog
Machine learning, to dziedzina informatyki skupiająca się na tworzeniu systemów, które potrafią uczyć się i dostosowywać do dostarczanych im danych. Jest to technologia bardzo ważna w dzisiejszym świecie, ponieważ pozwala na automatyzację procesów i zwiększenie efektywności w wielu dziedzinach, takich jak rozpoznawanie obrazów, analiza tekstu czy prognozowanie pogody.
Analiza predykcyjna to silne narzędzie, które pozwala przedsiębiorstwom odkrywać sekrety ukryte w gromadzonych danych. Stosując zaawansowane techniki statystyczne i modelowanie, możemy przewidzieć przyszłe tendencje, zachowania klientów i potencjalne ryzyka. W tym artykule omówimy pierwsze kroki, które musisz podjąć, aby zacząć korzystać z analizy predykcyjnej.
Sztuczna inteligencja rozwija się w błyskawicznym tempie, a jednym z jej najnowszych i najbardziej obiecujących osiągnięć jest technologia RAG (Retrieval-Augmented Generation). To innowacyjne podejście łączy możliwości generowania tekstu przez AI z dynamicznym wyszukiwaniem informacji w zewnętrznych źródłach. Dzięki temu odpowiedzi są nie tylko poprawne językowo, ale także aktualne i oparte na zweryfikowanych danych.
Computer Vision, czyli 'komputerowe widzenie', to technologia, która zrewolucjonizowała sposób, w jaki maszyny postrzegają i rozumieją nasz świat. Wykorzystując algorytmy sztucznej inteligencji, umożliwia komputerom 'widzenie' i interpretowanie obrazów i scen w sposób porównywalny z ludzkim percepcją. Powoduje to, że otwierają się przed nami nowe, niezwykłe możliwości.
Nowa era cyberprzestępczości nadejść może z kierunku, którego się nie spodziewaliśmy. Technologia Deepfake, wykorzystująca zaawansowane algorytmy AI do modyfikacji obrazu i dźwięku, zyskuje na sile. Otwiera ona niesłychane możliwości, ale za sobą niesie również prawdziwe zagrożenia. Czy jesteśmy na tę technologię gotowi?
Zarządzanie danymi, znane również jako Data Governance, to kluczowy proces w każdej organizacji opartej na danych. Celem jest zapewnienie wysokiej jakości, konsystencji i bezpieczeństwa informacji. To nie tylko techniczne wyzwanie, ale również kwestia regulacji prawnych, zasad etycznych oraz zarządzania ryzykiem.