Turso - nowoczesna baza danych oparta na SQLite. Co warto o niej wiedzieć?
Turso to baza danych oparta na SQLite, która pozwala dać każdemu klientowi osobną bazę, pracować offline z późniejszą synchronizacją i wyszukiwać dane po znaczeniu. Na przykładzie jednej aplikacji pokazujemy, co Turso daje na kolejnych etapach rozwoju produktu i kiedy lepiej wybrać coś innego.
SQLite to najpewniej najczęściej używana baza danych na świecie. Jest w każdym telefonie, w każdej przeglądarce i w tysiącach programów na komputery, ale w aplikacjach webowych pojawiała się rzadko, bo działa jako plik na jednej maszynie. Turso to nowoczesna baza danych oparta na SQLite, która wyprowadza ten plik do chmury. Pozwala trzymać tysiące małych baz, synchronizować je z urządzeniami użytkowników i wyszukiwać dane po znaczeniu, czego potrzebują funkcje AI.
Wokół Turso jest sporo zamieszania. Ta sama nazwa oznacza firmę, usługę w chmurze i nową bazę napisaną od zera, a obok funkcjonuje jeszcze libSQL. Część funkcji z pierwszych lat zniknęła, a część nowych dopiero dojrzewa.
Turso, libSQL i Turso Cloud, czyli kto jest kim
Zacznijmy od fundamentu. SQLite to baza danych, która nie potrzebuje serwera: cała baza to jeden plik, a program czyta go i zapisuje bezpośrednio. Według twórców SQLite w użyciu jest prawdopodobnie ponad bilion baz SQLite, głównie w smartfonach, z których każdy ma ich setki.
Na tym fundamencie wyrosły cztery rzeczy, które często wrzuca się do jednego worka:
libSQL - otwartoźródłowa odmiana SQLite rozwijana przez firmę Turso, która dokłada serwer, dostęp przez sieć, lokalne kopie bazy synchronizowane z chmurą i wyszukiwanie wektorowe,
Turso Database - nowa baza zgodna z SQLite, napisana od zera w języku Rust (wcześniej pod nazwą Limbo), która dodaje m.in. równoległe zapisy i działanie w przeglądarce; we wrześniu 2026 r. była jeszcze przed wersją 1.0,
Turso Cloud - usługa zarządzana na infrastrukturze AWS, z gałęziami bazy, przywracaniem danych do wybranego momentu i API do tworzenia tysięcy baz,
Turso - firma, która stoi za wszystkimi trzema projektami.
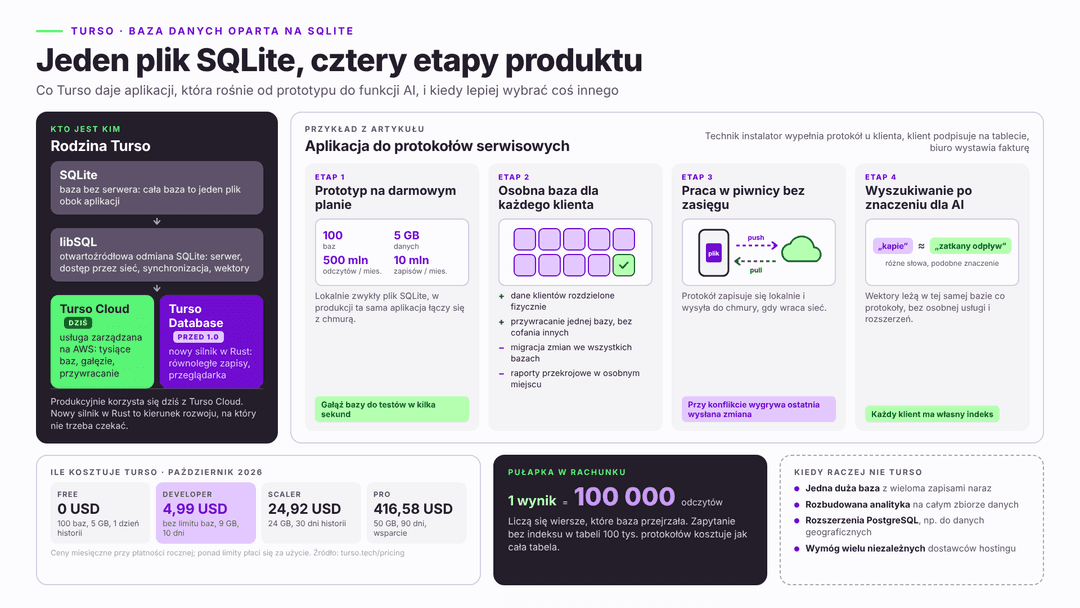
Dla firmy, która zamawia aplikację, sprawa jest prostsza, niż wygląda. Produkcyjnie korzysta się dziś z Turso Cloud. Nowa baza w Rust to kierunek, w którym firma się rozwija, ale żeby zacząć, nie trzeba na nią czekać. Sami twórcy przyznają w wyjaśnieniu nazw opublikowanym przez Pekkę Enberga, że nazewnictwo ewoluowało razem z produktem.
Dlaczego SQLite w ogóle trafia do aplikacji webowych
Klasyczne bazy, takie jak PostgreSQL czy MySQL, działają jako osobny serwer. Aplikacja łączy się z nim przez sieć, a serwer obsługuje wielu użytkowników naraz. To dobry model dla dużej, wspólnej bazy, ale każde zapytanie wymaga połączenia, a serwer działa i kosztuje przez całą dobę.
SQLite czyta dane z pliku leżącego obok programu. Odczyt trwa ułamek milisekundy, bo nie ma żadnej podróży przez sieć. Do tego SQLite to pełnoprawna baza relacyjna z transakcjami ACID, czyli gwarancją, że operacja zapisze się w całości albo wcale. Ograniczenia też są znane. Plik leży na jednej maszynie. W danej chwili zapisywać może tylko jeden proces. W modelu serverless, gdzie aplikacja uruchamia się na żądanie w krótko żyjących funkcjach, nie ma stałego dysku, na którym ten plik mógłby leżeć.
Turso rozwiązuje część tych problemów. Bazę trzyma w chmurze i udostępnia przez HTTP, więc łączy się z nią aplikacja na Vercelu, w funkcjach Cloudflare czy w AWS. A tam, gdzie liczy się szybkość albo praca bez sieci, trzyma lokalną kopię pliku i synchronizuje ją z chmurą.
Etap pierwszy: prototyp, który nic nie kosztuje
Weźmy firmę, która buduje aplikację do protokołów serwisowych dla instalatorów klimatyzacji. Technik przyjeżdża do klienta, sprawdza urządzenie, robi zdjęcia, wypełnia protokół, a klient podpisuje go na tablecie. Biuro widzi protokoły i na ich podstawie wystawia faktury. Na etapie MVP, czyli pierwszej wersji produktu do sprawdzenia na prawdziwych użytkownikach, baza ma być tania i nie zajmować czasu. Darmowy plan Turso (stan z października 2026 r.) obejmuje 100 baz, 5 GB danych, 500 mln odczytanych i 10 mln zapisanych wierszy miesięcznie. Dla prototypu z kilkoma firmami testowymi to aż nadto.
Programista pracuje lokalnie na zwykłym pliku SQLite, a w produkcji ta sama aplikacja łączy się z Turso. Oficjalne biblioteki są m.in. dla TypeScriptu i Pythona. Interfejs w Next.js może korzystać z Turso tak samo jak z każdej innej bazy, a do opisu tabel w kodzie nadaje się Drizzle ORM, który obsługuje Turso bezpośrednio. Prisma też działa, przez osobny adapter.
Przydaje się jeszcze jedna funkcja: gałęzie bazy. To kopia całej bazy tworzona w kilka sekund, na której można przetestować zmianę bez ryzyka dla danych produkcyjnych. W darmowym planie dane da się też przywrócić do stanu z dowolnego momentu ostatniej doby.
Etap drugi: osobna baza dla każdego klienta
Aplikację kupuje dwadzieścia firm instalacyjnych. Każda ma swoich techników, klientów i protokoły. Typowe rozwiązanie to jedna wspólna baza, w której każdy rekord ma znacznik „ta firma". Turso zachęca do innego podejścia: każda firma dostaje własną bazę. Różnice między tymi modelami dobrze widać przy porównaniu architektury single-tenant i multi-tenant.
Turso Cloud jest projektowane właśnie pod taki układ, z myślą o milionach małych baz. Płatne plany nie mają limitu liczby baz, a nowa baza powstaje przez API w chwili rejestracji klienta.
Co daje osobna baza
Dane klientów są od siebie oddzielone fizycznie, a nie tylko warunkiem w zapytaniu. Błąd programisty, który zapomni dopisać filtr po firmie, nie pokaże jednemu klientowi protokołów drugiego. Gdy klient odchodzi, eksport albo usunięcie danych to operacja na jednym pliku. Gdy ktoś w firmie instalacyjnej skasuje przez pomyłkę pół roku protokołów, przywraca się jedną bazę, bez cofania wszystkich pozostałych. Dla produktów typu SaaS jest jeszcze argument kosztowy. Mała, rzadko używana baza klienta nie zajmuje osobnego serwera, który pracuje całą dobę.
Co trzeba rozwiązać samemu
Zmiana struktury danych dotyczy teraz wszystkich baz naraz. Dodanie jednej kolumny oznacza migrację w dwudziestu, a potem w dwóch tysiącach baz, z obsługą sytuacji, w której część się nie powiedzie. W styczniu 2025 r. Turso wycofało dla nowych użytkowników funkcję wspólnych schematów dla wielu baz, więc ten mechanizm trzeba zbudować po swojej stronie.
Trudniejsze są też zestawienia przekrojowe. Pytanie „ile protokołów wypełnili wszyscy klienci w zeszłym miesiącu" wymaga zebrania danych z każdej bazy. Dlatego przy takim modelu zwykle od początku planuje się osobne miejsce na raporty, na przykład hurtownię danych zasilaną z baz klientów.
Etap trzeci: aplikacja, która działa w piwnicy bez zasięgu
Technicy pracują w kotłowniach, piwnicach i na dachach. Zasięg bywa tam słaby albo żaden. Aplikacja, która przy braku sieci nie pozwala zapisać protokołu, w tym zawodzie po prostu nie zadziała.
Turso Sync rozwiązuje to lokalnym plikiem bazy na urządzeniu. Technik zapisuje protokół lokalnie, a aplikacja wysyła zmiany do chmury, gdy sieć wraca, i pobiera to, co w międzyczasie zmieniło biuro. Według dokumentacji Turso Sync aplikacja może nawet wystartować bez połączenia, a zmiany czekają bezpiecznie w pliku do najbliższej synchronizacji. Jest jeden szczegół, który ma znaczenie biznesowe. Przy konflikcie obowiązuje zasada „wygrywa ostatnia wysłana zmiana". Jeśli technik i pracownik biura poprawią offline ten sam protokół, zostanie wersja tego, kto zsynchronizuje się później. Dlatego dane w takich aplikacjach projektuje się tak, żeby każdy edytował głównie swoje rekordy, a poprawki dopisywał jako nowe wpisy zamiast nadpisywać stare.
Trzeba też sprawdzić, na jakiej platformie będzie działać aplikacja. W październiku 2026 r. przykłady w dokumentacji Turso Sync dotyczyły TypeScriptu, Pythona i Go. Przy aplikacji mobilnej w React Native, Expo czy Flutterze aktualne wsparcie bibliotek trzeba zweryfikować przed decyzją. Czasem do prostszych przypadków wystarcza lokalne przechowywanie danych w React Native za pomocą AsyncStorage i własna synchronizacja.
Nowa baza Turso działa też w przeglądarce dzięki WebAssembly, czyli technologii uruchamiania skompilowanego kodu w przeglądarce. Otwiera to drogę do aplikacji PWA, które trzymają dane lokalnie i synchronizują je w tle. Przy takim projekcie decyzja o bazie wpływa na całą architekturę aplikacji, więc zapada razem z wyborem technologii w ramach tworzenia aplikacji mobilnych, a nie później.
Etap czwarty: wyszukiwanie po znaczeniu dla funkcji AI
Po roku w bazie jest kilka tysięcy protokołów z opisami usterek. Kierownik serwisu chce zapytać: „które urządzenia tego modelu miały problem z odpływem skroplin". Technicy opisują to różnie, raz „kapie z jednostki", raz „zatkany odpływ". Zwykłe wyszukiwanie po słowach znajdzie tylko część.Pomaga wyszukiwanie wektorowe. Każdy opis zamienia się na wektor, czyli ciąg liczb, który oddaje znaczenie tekstu, a system szuka opisów o podobnym znaczeniu, nawet gdy padają w nich inne słowa. Działa to na zasadzie wyszukiwania opartego na embeddingach. Turso ma wyszukiwanie wektorowe wbudowane, bez instalowania rozszerzeń. Wektory leżą w tej samej bazie co protokoły, więc w modelu „baza na klienta" każda firma ma też własny, odseparowany indeks. To dobry fundament pod RAG, czyli odpowiedzi modelu językowego oparte na danych firmy: asystent odpowiada na pytanie technika na podstawie historii jego firmy, a nie ogólnej wiedzy z internetu.
Przy bardzo dużych zbiorach, liczonych w dziesiątkach milionów wektorów, albo przy złożonym filtrowaniu wyników lepiej sprawdzają się wyspecjalizowane bazy wektorowe, takie jak Pinecone czy Qdrant. Dla tysięcy protokołów jednej firmy to zwykle przesada.
Turso dobrze pasuje do wielu małych baz, aplikacji z lokalną kopią danych i produktów, w których każdy klient żyje we własnym świecie. Poza tym obszarem pojawiają się sytuacje, w których lepiej sięgnąć po coś innego:
jedna duża baza, do której naraz zapisuje wielu użytkowników - równoległe zapisy są dopiero w nowej bazie Turso, przed wersją 1.0,
rozbudowana analityka i raporty na całym zbiorze danych, z wieloma złączeniami tabel,
potrzeba rozszerzeń znanych z PostgreSQL, na przykład do danych geograficznych,
wymóg technologii z wieloletnią historią i wieloma niezależnymi dostawcami hostingu.
Ostatni punkt dotyczy też zależności od dostawcy. Biblioteki klienckie i libSQL są otwartoźródłowe, ale w 2025 r. Turso zapowiedziało, że nowa część serwerowa usługi będzie rozwijana jako kod zamknięty. Plik SQLite da się zawsze wyeksportować i otworzyć gdzie indziej, ale funkcje takie jak synchronizacja czy gałęzie trzeba by wtedy odtworzyć inaczej.
W takich przypadkach rozsądną alternatywą jest PostgreSQL w modelu DBaaS, czyli bazy danych jako usługi. Dla aplikacji, która potrzebuje od razu logowania, plików i API, wygodny bywa Supabase. Przy prostych projektach z jednym serwerem sprawdza się PocketBase, też oparty na SQLite. Firmy z dużym ruchem na MySQL często wybierają PlanetScale.
Jak dobieramy bazę danych do projektu
Wybór bazy to decyzja na lata, a zmiana w trakcie życia produktu kosztuje dużo więcej niż na starcie. W pracy nad architekturą i infrastrukturą aplikacji dopasowujemy technologię do rzeczywistego obciążenia, budżetu i wymagań projektu, a nie do tego, o czym akurat głośno. Jeśli rozwiązania nie da się utrzymać w nocy, gdy coś przestanie działać, nie jest to oszczędność. Przy Turso zadajemy kilka konkretnych pytań. Ilu klientów ma mieć produkt i czy ich dane muszą być rozdzielone? Czy użytkownicy pracują w miejscach bez zasięgu? Czy będą potrzebne raporty przekrojowe? Jak duże będą zbiory danych za dwa lata? Odpowiedzi zwykle wyjaśniają sprawę szybciej niż porównywanie list funkcji.
Jeśli odpowiedzi nie są jeszcze znane, bo produkt dopiero powstaje, dobrym punktem wyjścia jest etap product discovery, na którym ustala się zakres pierwszej wersji i warunki, w jakich będzie działać. Wybór między Turso, PostgreSQL a innym rozwiązaniem robi się wtedy na podstawie konkretnych liczb i scenariuszy.
FAQ - Najczęściej zadawane pytania o bazę danych Turso
Tak, usługa Turso Cloud działająca na libSQL jest używana produkcyjnie i oferuje typowe zabezpieczenia usług zarządzanych, takie jak przywracanie danych do wybranego momentu. Trzeba ją przy tym odróżnić od nowej bazy Turso napisanej od zera w języku Rust, która jesienią 2026 r. była jeszcze przed wersją 1.0 i dopiero wprowadzała część funkcji, na przykład równoległe zapisy. Dla aplikacji z wieloma małymi bazami, na przykład systemu SaaS, w którym każdy klient ma własną bazę, Turso Cloud jest dojrzałym wyborem. Przy projektach, które od początku zakładają intensywne zapisy do jednej dużej bazy, decyzja zależy od tego, na jakim etapie rozwoju będzie wtedy nowy silnik i czy jego ograniczenia są akceptowalne.
Tak, istniejący plik SQLite można przenieść do Turso, bo obie bazy korzystają z tego samego formatu danych i tego samego języka zapytań. Narzędzie wiersza poleceń Turso pozwala utworzyć nową bazę w chmurze na podstawie lokalnego pliku, a aplikacja wymaga potem głównie zmiany sposobu połączenia z bazą. Przykładowo wewnętrzne narzędzie, które działało na serwerze firmy z plikiem SQLite na dysku, można przenieść do Turso i uruchomić w modelu serverless bez przepisywania zapytań. Czas i trudność takiej przeprowadzki zależą od wielkości bazy, od tego, czy aplikacja korzysta z nietypowych rozszerzeń SQLite, oraz od tego, ile miejsc w kodzie bezpośrednio otwiera plik bazy.
Tak, przejście z Turso na PostgreSQL jest możliwe, choć wymaga migracji danych i dostosowania części kodu. SQLite i PostgreSQL używają języka SQL, ale różnią się typami danych, funkcjami wbudowanymi i niektórymi szczegółami składni, więc część zapytań trzeba przepisać. Jeśli aplikacja korzysta z ORM, czyli warstwy, która tłumaczy kod programu na zapytania do bazy, takiego jak Drizzle czy Prisma, zmian jest zwykle mniej. Przy modelu z osobną bazą dla każdego klienta dochodzi decyzja, czy połączyć dane w jedną bazę PostgreSQL, czy zachować rozdział. Czas takiej migracji to zwykle od kilku dni dla małej aplikacji z jedną bazą do kilku tygodni przy wielu bazach klientów i rozbudowanej logice.
Tak, Turso współpracuje z aplikacjami w Next.js hostowanymi na Vercelu, a także z innymi platformami serverless. Połączenie odbywa się przez HTTP, więc nie wymaga stałego połączenia z serwerem bazy, które w krótko żyjących funkcjach serverless sprawia zwykle problemy. W praktyce aplikacja korzysta z oficjalnej biblioteki dla TypeScriptu, a strukturę tabel opisuje się w Drizzle ORM albo w Prisma z odpowiednim adapterem. Przykładowo panel klienta w Next.js może pobierać dane z bazy danego klienta w Turso w trakcie renderowania strony na serwerze. Wydajność zależy głównie od tego, w jakim regionie działa baza w stosunku do regionu funkcji Vercela, dlatego oba ustawia się możliwie blisko siebie.
Samo podłączenie Turso do nowej aplikacji zajmuje zwykle od kilku godzin do kilku dni pracy programisty. Tyle trwa utworzenie bazy, konfiguracja połączenia, opisanie tabel i uruchomienie pierwszych zapytań, zwłaszcza gdy zespół zna już SQLite. Dłużej trwa przygotowanie architektury wokół bazy: przy modelu z osobną bazą dla każdego klienta trzeba zbudować automatyczne tworzenie baz przy rejestracji, mechanizm migracji wszystkich baz i osobne miejsce na raporty przekrojowe, co zajmuje zwykle od jednego do kilku tygodni. Przy aplikacji działającej offline dochodzi zaprojektowanie synchronizacji i rozwiązywania konfliktów. Całość zależy więc mniej od samej bazy, a bardziej od tego, z których funkcji Turso aplikacja korzysta.
Tak, Turso Cloud pozwala przywrócić bazę do stanu z wybranego momentu w przeszłości, a długość dostępnej historii zależy od planu. W październiku 2026 r. było to od jednego dnia w planie darmowym, przez 10 dni w planie Developer i 30 dni w planie Scaler, do 90 dni w planie Pro. Przykładowo, jeśli pracownik klienta przez pomyłkę usunie część rekordów, bazę tego klienta można odtworzyć do stanu sprzed błędu bez wpływu na pozostałych klientów, o ile każdy ma osobną bazę. Niezależnie od tego bazę można wyeksportować do pliku SQLite i przechowywać kopie we własnym miejscu, co przydaje się przy dłuższych wymaganiach dotyczących archiwizacji.
Tak, Turso ma wbudowane wyszukiwanie wektorowe, więc dane do funkcji AI można trzymać w tej samej bazie co resztę danych aplikacji. Wyszukiwanie wektorowe pozwala znaleźć rekordy o podobnym znaczeniu, nawet gdy użyto w nich innych słów, co wykorzystuje się w asystentach odpowiadających na pytania na podstawie dokumentów firmy. Przykładowo aplikacja dla biura rachunkowego może przechowywać w bazie każdego klienta opisy faktur wraz z ich wektorami i podpowiadać kategorię kosztu na podstawie podobnych dokumentów z przeszłości. Takie rozwiązanie sprawdza się przy tysiącach i setkach tysięcy rekordów na bazę. Przy dziesiątkach milionów wektorów albo złożonym filtrowaniu wyników lepiej sprawdza się wyspecjalizowana baza wektorowa.
SQLite to popularna, lekka baza danych relacyjna, która jest szeroko stosowana w projektach programistycznych na całym świecie. Dzięki swojej prostocie i elastyczności, jest często wykorzystywana jako narzędzie do przechowywania i zarządzania danymi w aplikacjach mobilnych, desktopowych, a także webowych.
Neon to PostgreSQL w modelu serverless: baza usypia, gdy nikt z niej nie korzysta, rośnie przy większym ruchu i pozwala w sekundę zrobić kopię do testów. Na pięciu typowych projektach pokazujemy, kiedy to się opłaca, a kiedy nie.
Poznaj Drizzle-ORM, potężne narzędzie do zarządzania bazami danych, które usprawni Twoją pracę w obszarze programowania. Dowiedz się, jak wykorzystać jego funkcje do efektywnej manipulacji danymi, optymalizacji zapytań i zintegrowania z różnymi platformami. Nasz przewodnik po Drizzle-ORM poprowadzi Cię przez proces od podstaw do zaawansowanych technik.
DBaaS, czyli Database as a Service, to nowoczesne podejście do zarządzania bazami danych w chmurze. Dzięki temu rozwiązaniu, administracja staje się łatwiejsza, efektywniejsza i mniej czasochłonna. W artykule poznamy bliżej na czym polega fenomen DBaaS i jak wpływa na proces administracji bazami danych.
Wybór między modelami Single-tenant i Multi-tenant to jedno z kluczowych decyzji, które mogą wpływać na skalowalność i wydajność naszego biznesu w kontekście IT. Ten artykuł pomoże Ci zrozumieć różnice między nimi i określić, która opcja jest najlepsza dla Twojej firmy.
Sztuczna inteligencja rozwija się w błyskawicznym tempie, a jednym z jej najnowszych i najbardziej obiecujących osiągnięć jest technologia RAG (Retrieval-Augmented Generation). To innowacyjne podejście łączy możliwości generowania tekstu przez AI z dynamicznym wyszukiwaniem informacji w zewnętrznych źródłach. Dzięki temu odpowiedzi są nie tylko poprawne językowo, ale także aktualne i oparte na zweryfikowanych danych.