SigNoz jako open-source'owa alternatywa dla Datadog
SigNoz to otwartoźródłowa platforma do monitorowania aplikacji, która łączy logi, metryki i ślady żądań w jednym miejscu, podobnie jak Datadog. Porównujemy model kosztów, funkcje, czego w SigNoz brakuje i jak wygląda przejście z Datadog bez przerwy w monitoringu.
Rachunek za Datadog to w wielu firmach jedna z tych pozycji, które rosną szybciej niż ruch w aplikacji. Każdy nowy serwer, każdy gigabajt logów i każda dodatkowa metryka mają swoją cenę, a po roku trudno powiedzieć, za co właściwie się płaci. SigNoz jako open-source'owa alternatywa dla Datadog daje podobny zestaw narzędzi do monitorowania aplikacji, z kodem dostępnym publicznie i możliwością uruchomienia na własnych serwerach albo w tańszej chmurze.
Nie znaczy to, że SigNoz jest Datadogiem za darmo. Część funkcji po prostu w nim nie istnieje. Wersja na własnych serwerach przenosi z kolei koszt z faktury na ludzi, którzy ją utrzymują.
Logi, metryki i ślady, czyli o czym w ogóle rozmawiamy
Obie platformy zajmują się tym, co po angielsku nazywa się observability, a po polsku obserwowalnością: możliwością zrozumienia, co dzieje się w działającej aplikacji, bez zgadywania. Opiera się ona na trzech rodzajach danych. Logi to zapisy zdarzeń, które aplikacja zostawia po sobie: „użytkownik zalogował się", „płatność odrzucona", „błąd połączenia z bazą". Metryki to liczby mierzone w czasie, na przykład użycie procesora, liczba zapytań na sekundę czy czas odpowiedzi. Ślady, czyli traces, pokazują drogę jednego żądania przez cały system: od kliknięcia użytkownika, przez kolejne usługi, aż po bazę danych i z powrotem.
Ślady są szczególnie przydatne w architekturze mikroserwisowej, gdzie jedno kliknięcie przechodzi przez kilka czy kilkanaście usług. Technikę ich zbierania, czyli distributed tracing, wspierają dziś wszystkie poważne narzędzia do monitoringu.
Kiedyś do każdego rodzaju danych używało się osobnego narzędzia: Prometheusa do metryk, Splunka albo ELK do logów, Jaegera do śladów, a Grafany do wykresów. Datadog, podobnie jak New Relic, zdobył rynek między innymi tym, że połączył wszystko w jednym miejscu. SigNoz robi to samo, tyle że na otwartym kodzie.
Skąd się bierze rachunek za Datadog
Datadog rozlicza się z każdym modułem osobno. Według cennika Datadog z października 2026 r. monitoring infrastruktury w planie Pro kosztuje 15 USD za serwer miesięcznie przy umowie rocznej, monitoring aplikacji (APM) od 31 USD za serwer, a logi rozlicza się podwójnie: 0,10 USD za każdy przyjęty gigabajt i 1,70 USD za każdy milion zdarzeń zapisanych do przeszukiwania. Dodatkowe własne metryki ponad limit w planie też są płatne.
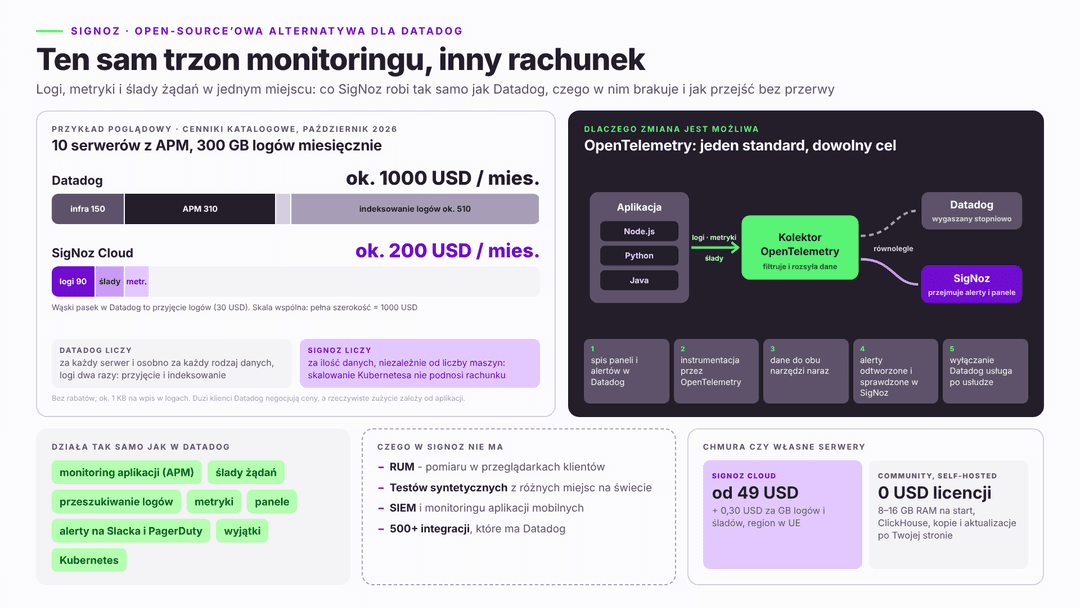
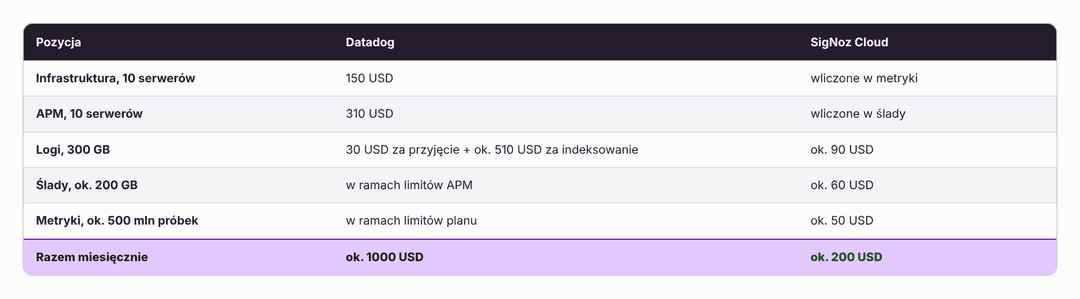
Każda pozycja z osobna wygląda niewinnie. Problem pojawia się, gdy zaczyna się je mnożyć. Przykład poglądowy dla niewielkiego systemu: 10 serwerów z monitoringiem infrastruktury i APM oraz 300 GB logów miesięcznie, czyli przy przeciętnym rozmiarze wpisu około 300 mln zdarzeń. Według cennika katalogowego, bez rabatów:
Liczby trzeba traktować jako rząd wielkości, a nie wycenę. Duzi klienci Datadog negocjują rabaty, SigNoz liczy inaczej retencję danych, a rzeczywiste zużycie zależy od tego, ile aplikacja loguje. Różnica w samym modelu rozliczeń jest jednak wyraźna. W Datadog płaci się za liczbę serwerów i osobno za każdy rodzaj danych. W SigNoz płaci się za ilość danych, niezależnie od tego, na ilu maszynach działa aplikacja.
Ma to znaczenie zwłaszcza przy Kubernetesie, gdzie liczba maszyn rośnie i maleje automatycznie razem z ruchem. W modelu „za serwer" każde skalowanie w górę podnosi rachunek za monitoring, nawet jeśli aplikacja nie generuje więcej logów. Firmy, które pilnują kosztów samego klastra narzędziami takimi jak Kubecost, często dopiero wtedy zauważają, że monitoring kosztuje porównywalnie z infrastrukturą, którą monitoruje.
SigNoz jako open-source'owa alternatywa dla Datadog: co działa tak samo
SigNoz pokrywa podstawowy zakres, którego zespoły używają w Datadog na co dzień. Monitoring aplikacji pokazuje czas odpowiedzi, liczbę błędów i najwolniejsze miejsca w kodzie. Ślady żądań można oglądać na wykresie, który pokazuje, ile czasu zajęła każda usługa i każde zapytanie do bazy. Logi przeszukuje się w jednym miejscu, a z wpisu w logu przechodzi się jednym kliknięciem do śladu żądania, które go wygenerowało. Do tego dochodzą panele z wykresami, alerty wysyłane do Slacka, PagerDuty albo przez webhooki, śledzenie wyjątków i monitoring infrastruktury, w tym klastrów Kubernetes. Zespół, który pracował w Datadog, odnajdzie się w SigNoz szybko, bo pojęcia i układ ekranów są podobne.
Projekt ma solidne zaplecze. Według porównania SigNoz i Datadog z marca 2026 r. repozytorium ma ponad 24 tys. gwiazdek na GitHubie i około 10 mln pobrań obrazów Dockera. To nie jest eksperyment jednego programisty.
Pod spodem SigNoz przechowuje dane w ClickHouse, kolumnowej bazie danych zaprojektowanej do szybkiego przeszukiwania bardzo dużych ilości zapisów. To dzięki niej zapytania po miliardach wierszy logów zwracają wyniki w sekundy.
Czego w SigNoz nie ma
Uczciwe porównanie wymaga tej listy. Datadog przez lata rozrósł się do kilkudziesięciu produktów, a SigNoz skupia się na trzonie obserwowalności. Według tego samego porównania z marca 2026 r. w SigNoz brakuje między innymi:
monitoringu prawdziwych użytkowników (RUM), czyli pomiaru, jak szybko strona ładuje się w przeglądarkach klientów i gdzie się zacinają,
testów syntetycznych, które co kilka minut sprawdzają z różnych miejsc na świecie, czy kluczowe ścieżki aplikacji działają,
funkcji bezpieczeństwa typu SIEM, analizujących logi pod kątem ataków,
monitoringu aplikacji mobilnych na urządzeniach użytkowników,
tak dużej liczby gotowych integracji, bo Datadog ma ich ponad 500.
Część tych luk da się zapełnić osobnymi narzędziami. Zachowanie użytkowników na stronie pokaże Microsoft Clarity, dostępność z zewnątrz sprawdzi prosty UptimeRobot, a błędy w aplikacjach frontendowych i mobilnych dobrze wyłapuje Sentry. To jednak kolejne narzędzia do utrzymania, więc oszczędność na fakturze częściowo się zmniejsza.
OpenTelemetry, czyli dlaczego zmiana jest w ogóle możliwa
Przez lata przejście z jednego narzędzia do monitoringu na inne oznaczało przepisywanie kodu. Każdy dostawca miał własne biblioteki, które programiści wpinali w aplikację, a ich wymiana dotykała setek miejsc. Zmienił to OpenTelemetry, otwarty standard zbierania logów, metryk i śladów, rozwijany przez fundację CNCF. Aplikacja wysyła dane w jednym, uniwersalnym formacie, a o tym, gdzie trafią, decyduje konfiguracja, a nie kod. Biblioteki istnieją dla wszystkich popularnych języków, w tym Node.js, Pythona i Javy.
SigNoz od początku powstawał wokół OpenTelemetry. Datadog też go obsługuje, choć najpełniej działa z własnym agentem. W praktyce oznacza to, że aplikacja zinstrumentowana przez OpenTelemetry może wysyłać dane równocześnie do Datadog i do SigNoz. To otwiera drogę do bezpiecznej migracji, o której piszemy niżej, i chroni firmę przed uzależnieniem od jednego dostawcy na przyszłość.
Chmura SigNoz czy własne serwery
SigNoz można używać na dwa sposoby, a wybór zmienia rachunek bardziej, niż się wydaje.
Wersja chmurowa, według cennika SigNoz z października 2026 r., zaczyna się od 49 USD miesięcznie, w tym 49 USD użycia. Logi i ślady kosztują 0,30 USD za przyjęty gigabajt z 15-dniową retencją, metryki 0,10 USD za milion próbek. Dane mogą być przechowywane w centrach danych w Europie. Plan Enterprise, z dedykowaną instancją albo instalacją na koncie chmurowym klienta, zaczyna się od 4000 USD miesięcznie.
Wersja Community na własnych serwerach nie ma opłat licencyjnych. Ma za to wymagania sprzętowe: według wspomnianego porównania minimum to 8 GB pamięci RAM i 4 rdzenie procesora, a w produkcji raczej 16 GB i 8 rdzeni, przy czym przy dużych ilościach logów to dopiero początek. Instaluje się ją przez Dockera albo w Kubernetesie za pomocą Helma.
Prawdziwy koszt własnej instalacji to jednak czas ludzi. Ktoś musi pilnować miejsca na dyskach, kopii zapasowych bazy ClickHouse, aktualizacji i tego, żeby sam system monitoringu nie przestał działać akurat wtedy, gdy jest najbardziej potrzebny. Przy ważnych systemach oznacza to projektowanie go z myślą o wysokiej dostępności, tak samo jak samej aplikacji. Przy jednym, niewielkim systemie chmura SigNoz zwykle wychodzi taniej niż etat na utrzymanie. Własne serwery opłacają się raczej przy dużych ilościach danych, kiedy różnica w rachunku pokrywa pracę zespołu, albo gdy dane nie mogą opuszczać infrastruktury firmy.
Jak przejść z Datadog na SigNoz bez przerwy w monitoringu
Najgorszy scenariusz migracji to wyłączenie Datadog w piątek i odkrycie w sobotę, że połowa alertów nie działa. Dlatego przejście robi się etapami, z okresem, w którym oba systemy pracują równolegle:
Inwentaryzacja tego, co jest w Datadog: panele, alerty, monitorowane usługi, osoby powiadamiane o awariach. Zwykle okazuje się, że część z nich nikt nie ogląda.
Instrumentacja aplikacji przez OpenTelemetry, jeśli dotąd używała agenta Datadog, zaczynając od jednej usługi.
Równoległe wysyłanie danych do Datadog i do SigNoz przez kolektor OpenTelemetry, czyli pośrednika, który odbiera dane z aplikacji i rozsyła je dalej.
Odtworzenie najważniejszych alertów i paneli w SigNoz oraz sprawdzenie ich na prawdziwych zdarzeniach.
Wyłączenie Datadog dla kolejnych usług dopiero wtedy, gdy zespół przez kilka tygodni reaguje na alerty z SigNoz.
Najwięcej pracy wymaga zwykle punkt czwarty. Alerty w Datadog bywają budowane latami, z progami dobranymi po kolejnych awariach, i trzeba je przenieść z tą wiedzą, a nie tylko z ustawieniami.
W pracy nad architekturą i infrastrukturą aplikacji traktujemy monitoring jako coś, co ma zaalarmować zespół, zanim problem zauważy klient, a nie jako zestaw kolorowych wykresów. Przy takiej migracji to dobry moment, żeby uporządkować, co naprawdę trzeba mierzyć, zgodnie z praktykami Site Reliability Engineering.
Kiedy lepiej zostać przy Datadog
SigNoz nie jest dobrym wyborem dla każdego. Zostanie przy Datadog ma sens, gdy firma intensywnie korzysta z funkcji, których SigNoz nie ma, na przykład monitoringu użytkowników, testów syntetycznych czy analizy bezpieczeństwa. Także wtedy, gdy wynegocjowane rabaty sprawiają, że różnica w kosztach jest niewielka, albo gdy zespół nie ma czasu na migrację, a rachunek nie jest problemem.
Podobnie jest przy bardzo prostych systemach. Jedna aplikacja na kilku serwerach często obejdzie się narzędziami dostawcy chmury, takimi jak Amazon CloudWatch w AWS, bez osobnej platformy obserwowalności.
SigNoz najlepiej sprawdza się tam, gdzie rachunek za monitoring urósł do poziomu, przy którym ktoś w końcu zapytał, za co płacimy, a firma korzysta głównie z logów, metryk, śladów i alertów. Jeśli chcesz sprawdzić, ile mógłby kosztować monitoring Twojej aplikacji w SigNoz i jak przeprowadzić przejście bez ryzyka, porozmawiajmy o Twojej infrastrukturze.
FAQ
FAQ - Najczęściej zadawane pytania o SigNoz
Tak, wersja SigNoz Community instalowana na własnych serwerach jest bezpłatna i nie ma limitów liczby użytkowników ani monitorowanych usług. Płaci się wtedy wyłącznie za infrastrukturę, na której działa, oraz za czas osób, które ją utrzymują. Dla firm, które nie chcą zajmować się serwerami, jest płatna wersja chmurowa: w październiku 2026 r. zaczynała się od 49 USD miesięcznie, a dalsze opłaty zależały od ilości przesłanych logów, śladów i metryk. Przykładowo mały zespół z jedną aplikacją może przez pierwsze miesiące zmieścić się blisko kwoty bazowej, a koszt rośnie dopiero razem z ruchem. Wybór między wersją darmową a chmurową zależy głównie od tego, czy zespół ma czas i kompetencje do utrzymania bazy ClickHouse.
Przejście z Datadog na SigNoz trwa zwykle od kilku tygodni przy kilku usługach do kilku miesięcy w rozbudowanych systemach. Najkrócej trwa uruchomienie SigNoz i podłączenie pierwszej aplikacji, zwłaszcza jeśli korzysta już ze standardu OpenTelemetry. Najwięcej czasu zajmuje przeniesienie alertów i paneli, które w Datadog powstawały latami, oraz okres równoległego działania obu narzędzi, potrzebny do sprawdzenia, że nowe alerty reagują na prawdziwe awarie. Czas zależy od liczby usług, od tego, czy aplikacje używają agenta Datadog, czy OpenTelemetry, oraz od liczby integracji z innymi narzędziami. Przy dużych systemach migrację prowadzi się usługa po usłudze, zamiast przełączać wszystko jednego dnia.
Tak, SigNoz monitoruje klastry Kubernetes i aplikacje w nich działające, a sam może być w Kubernetesie zainstalowany za pomocą gotowego pakietu Helm. Zbiera metryki węzłów, podów i kontenerów, logi aplikacji oraz ślady żądań przechodzących między usługami. Przykładowo zespół może zobaczyć na jednym ekranie, że wzrost czasu odpowiedzi sklepu internetowego zbiegł się z restartem podów usługi płatności i brakiem pamięci na jednym z węzłów. Model rozliczeń w wersji chmurowej opiera się na ilości danych, a nie liczbie maszyn, więc automatyczne skalowanie klastra nie podnosi rachunku samo w sobie. Zakres danych zależy od konfiguracji kolektora OpenTelemetry w klastrze.
Tak, SigNoz Cloud oferuje centrum danych w Unii Europejskiej, a wersję instalowaną samodzielnie można uruchomić w dowolnej lokalizacji, także na własnych serwerach firmy. Ma to znaczenie, gdy logi zawierają dane klientów, na przykład adresy e-mail czy identyfikatory zamówień, a firma chce, aby nie opuszczały Europy. Przykładowo polski sklep internetowy może wybrać europejski region chmury SigNoz albo zainstalować SigNoz na swoim koncie chmurowym we Frankfurcie. Niezależnie od lokalizacji dobrą praktyką jest usuwanie lub maskowanie danych osobowych jeszcze przed wysłaniem logów, co da się skonfigurować w kolektorze OpenTelemetry.
Tak, SigNoz przyjmuje dane ze wszystkich języków obsługiwanych przez standard OpenTelemetry, w tym Node.js, Pythona, Javy, Go, .NET, PHP i Ruby. W wielu z nich działa automatyczna instrumentacja, czyli zbieranie śladów żądań, zapytań do bazy i wywołań zewnętrznych usług bez ręcznego dopisywania kodu w każdym miejscu. Przykładowo aplikację w Javie można podłączyć, dodając agenta OpenTelemetry przy uruchomieniu, a aplikację w Node.js przez dołączenie odpowiedniej biblioteki przy starcie. Szczegółowe pomiary specyficzne dla biznesu, takie jak czas finalizacji zamówienia, wymagają już dopisania kilku linii kodu. Zakres automatycznego zbierania danych zależy od użytych frameworków i bibliotek.
Tak, koszty logów w SigNoz można ograniczyć, filtrując dane przed wysłaniem, skracając czas przechowywania i próbkując część śladów. Filtrowanie ustawia się w kolektorze OpenTelemetry: można na przykład odrzucać logi poziomu debug z produkcji albo powtarzalne wpisy z kontroli stanu aplikacji, które często stanowią dużą część całego wolumenu. W wersji chmurowej wybiera się też okres przechowywania, od 15 dni do roku, a dłuższy okres kosztuje więcej. Przykładowo zespół, który zaczyna od wysyłania wszystkiego, po pierwszym miesiącu zwykle widzi, które źródła generują najwięcej danych i nie są do niczego potrzebne. Skala oszczędności zależy od tego, jak dużo zbędnych logów aplikacja produkuje i jak długo dane muszą być dostępne.
W złożonych systemach IT, scentralizowany monitoring i debugging staje się wyzwaniem. Śledzenie rozproszone (Distributed Tracing) umożliwia lepsze zrozumienie jak dane przepływają przez mikrousługi. Jest to klucz do efektywnego zarządzania i ulepszania architektury IT.
Architektura mikroserwisowa staje się nowym standardem w budowie i zarządzaniu aplikacjami. Pozwalając na podzielenie całego systemu na mniejsze, niezależne serwisy, ułatwia naszą pracę, podnosi wydajność i skalowalność. Czy to oznacza, że mikroserwisy są przyszłością IT? Przyjrzyjmy się bliżej tej koncepcji.
Prometheus, powszechnie używany system monitorowania open-source, oferuje narzędzia umożliwiające śledzenie wydajności systemów. Prawidłowy monitoring jest kluczowy dla skutecznego zarządzania infrastrukturą IT, zapewniając jej nieprzerwaną dostępność oraz optymalizację zasobów.
W dzisiejszych czasach monitoring aplikacji to klucz do zrozumienia jej działania. Grafana, jako nowoczesne narzędzie monitoringu, umożliwia tworzenie interaktywnych dashboardów, które pomogą Ci w ciągu sekund zdiagnozować problemy i zrozumieć złożoność Twojego systemu. Zatrzymaj się na chwilę i odkryj moc Grafany.
W dynamicznie rozwijającym się świecie IT, rola efektywnego monitoringu aplikacji staje się nieodzowna. Nowe technologie, jak New Relic, stwarzają coraz większe możliwości monitorowania, analizy i poprawy wydajności naszych aplikacji. Pozwala to na natychmiastowe reagowanie na ewentualne problemy. W naszym kolejnym artykule przyjrzymy się temu narzędziu bliżej.
SRE (Site Reliability Engineering) to innowacyjna koncepcja w dziedzinie IT, która powstała w Google, a która teraz zdobywa popularność na całym świecie. Stanowi ona klucz do zapewnienia niezawodności Twojej strony. SRE łączy umiejętności programistyczne z wiedzą operacyjną, aby zoptymalizować niezawodność i wydajność strony internetowej.