
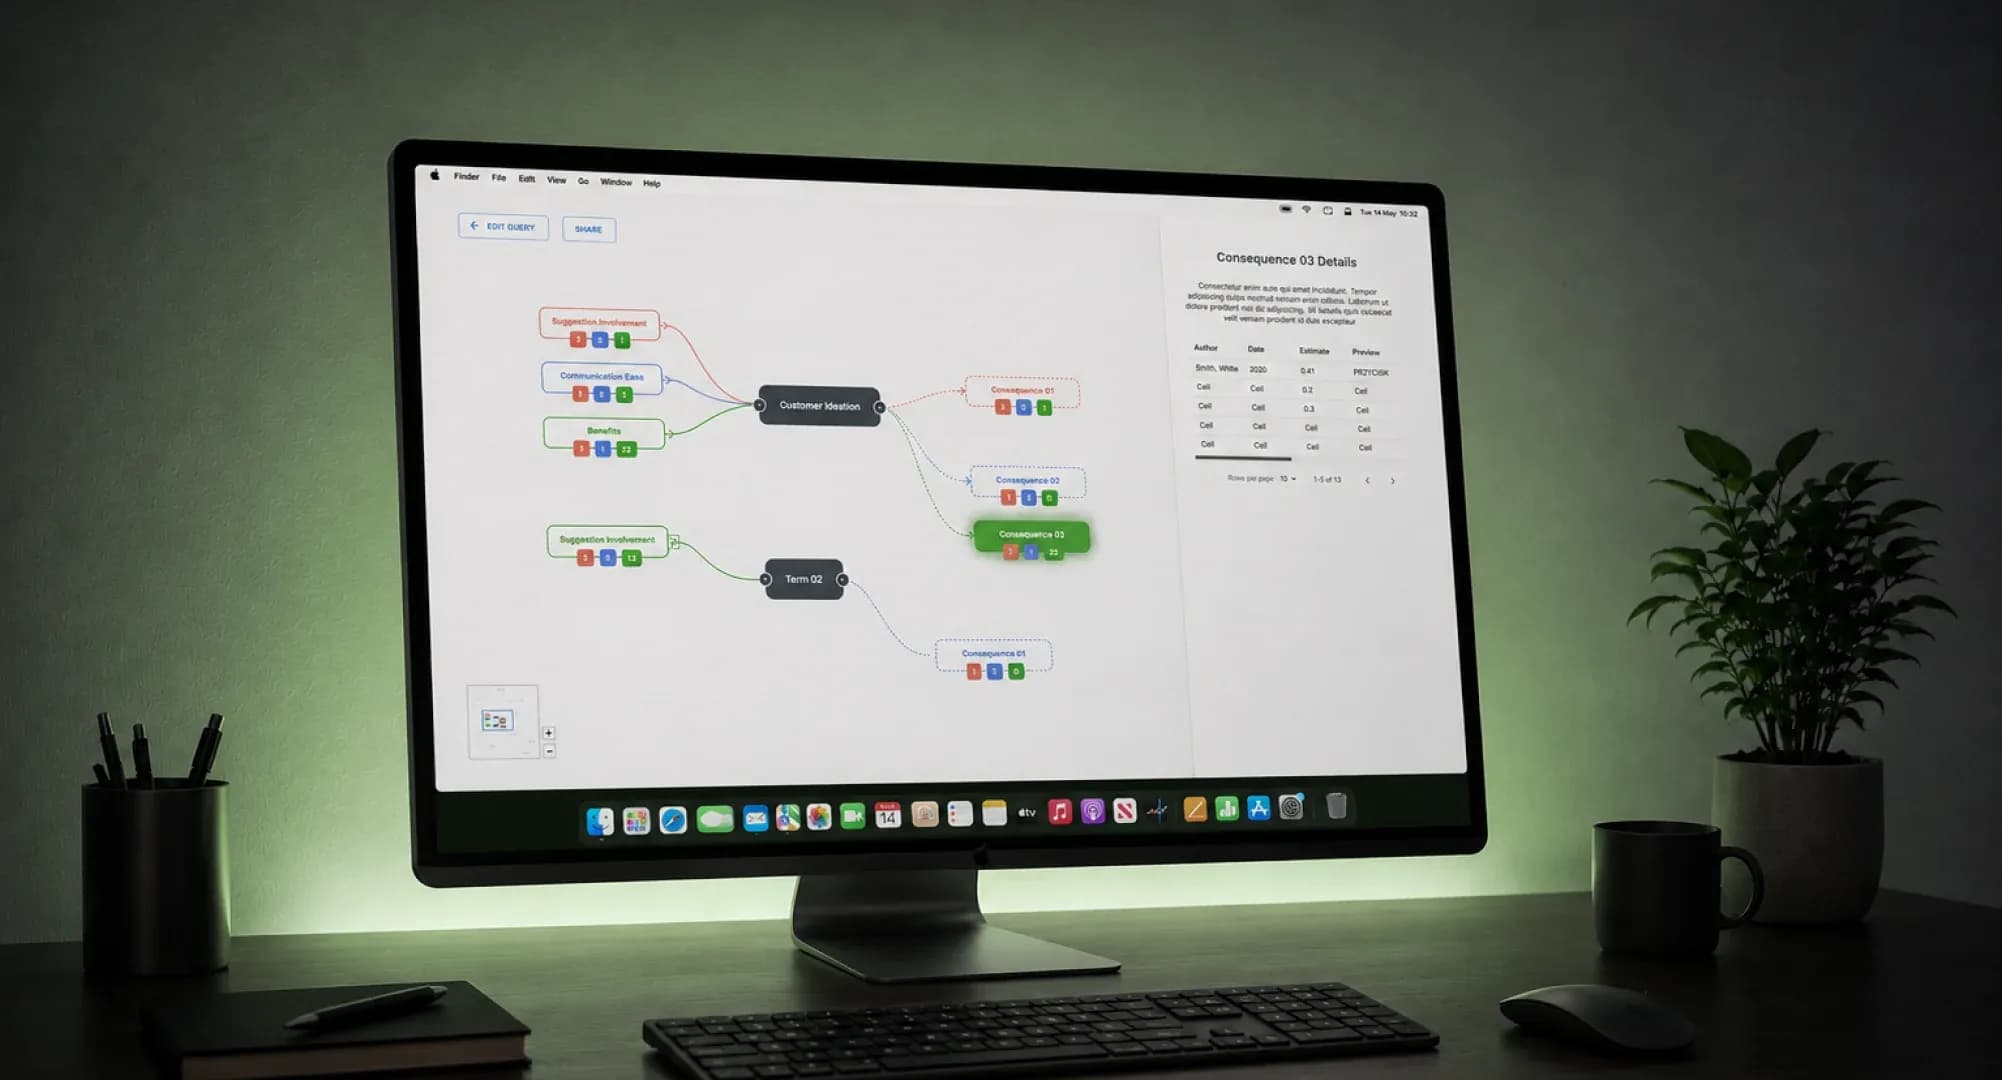
Interaktywna mapa zależności, która skraca analizę literatury naukowej
Klient: Klient (Mapowanie badań naukowych)
Branża: Edukacja / EdTech
Big Data, czyli duże zbiory danych, nieustannie zyskują na znaczeniu w świecie IT. Nowe możliwości analizy i przetwarzania tychże daje Apache Samza - otwarte oprogramowanie stworzone przez Apache Software Foundation. Wspierającym nas procesor strumieniowy o wysokim przepustowości, Samza pomaga rozwijać potęgę Big Data. W tym artykule zajmiemy się szczegółami i możliwościami wynikającymi z korzystania z Apache Samza.

CEO
25 wrz 2023
Big Data to dziedzina, która prężnie się rozwija i umożliwia przechowywanie oraz analizowanie ogromnych ilości danych. W tym kontekście Apache Samza, jako system przetwarzania strumieniowego Big Data, posiada kluczowe znaczenie. Samza oferuje skalowalną platformę, która pozwala na przetwarzanie i przechowywanie miliardów zdarzeń w czasie rzeczywistym. W połączeniu z Apache Kafka, Samza jest w stanie obsługiwać ogromne strumienie danych i zapewniać cenne informacje, które mogą być wykorzystane w decyzyjnych procesach biznesowych.
Klient: Klient (Mapowanie badań naukowych)
Branża: Edukacja / EdTech
Apache Samza to otwartoźródłowy system przetwarzania strumieniowego, który skupia się na przetwarzaniu i analizie Big Data w czasie rzeczywistym. Jego architektura, zbudowana na Apache Kafka i YARN, pozwala na wysoką przepustowość i skalowalność, a także zapewnia niezawodność i wydajność przetwarzania. Jego przyjazne dla dewelopera API i możliwość równoczesnego przetwarzania strumieniowego i batchowego, sprawia, że jest to atrakcyjne narzędzie do zastosowania w różnych scenariuszach Big Data. Korzyści z wykorzystania Apache Samza to, m.in. elastyczność w przetwarzaniu danych, łatwość tworzenia i obsługi dużych strumieni danych, a przede wszystkim możliwość rozszerzania analizy danych w czasie rzeczywistym.
Apache Samza, będąc potężnym frameworkiem do przetwarzania strumieniowego Big Data, doskonale współpracuje z innymi narzędziami z tego samego ekosystemu. Jego integracja z systemami Big Data takimi jak Apache Kafka czy Hadoop, pozwala na tworzenie kompleksowych i skalowalnych rozwiązań do analizy ogromnych zbiorów danych. Jest idealny do przetwarzania działającego w czasie rzeczywistym, gwarantując szybką reakcję na zmieniające się dane. Dzięki dostępności API dla różnych języków programowania, a także łatwości integracji z chmurami obliczeniowymi, Apache Samza jest uniwersalnym narzędziem, które pozwala na rozszerzanie horyzontów Big Data.
Jako mocne narzędzie do przetwarzania strumieniowego, znajduje praktyczne zastosowanie w obszarze Big Data, oferując szereg istotnych możliwości. Jest to niezwykle przydatne, szczególnie przy monitorowaniu w czasie rzeczywistym, analizie sesji użytkownika czy detekcji anomalii. Samza pozwala na przetwarzanie i agregację dużych strumieni danych na bardzo wysokim poziomie. Dodatkowo, dzięki swojej naturze open source, zapewnia wolność i wygodę w dostosowywaniu narzędzia do indywidualnych potrzeb i wymagań, sprawiając, że obszar Big Data staje się o wiele bardziej dostępny i łatwiejszy do zarządzania.
Przyszłość Big Data wydaje się nierozerwalnie związana z Apache Samza, nowoczesnym systemem do przetwarzania strumieniowego i rozproszonego. Oferuje szczegółowy mechanizm przetwarzania, zapewniając równocześnie skalowalność i niezawodność, które są kluczowe dla dużych zbiorów danych. Dzięki integracji z Apache Kafka, Samza z łatwością obsługuje strumienie o nieograniczonej wielkości, a przy tym jest w stanie zapewnić stabilność i niezawodność przetwarzania. Dodatkowo, zapewnia wyjątkowo dobrą obsługę stanu, co czyni go idealnym narzędziem do tworzenia aplikacji o dużym stopniu złożoności. Wszystko to czyni Apache Samze nie tylko kluczowym graczem na obecnym rynku Big Data, ale także cennym narzędziem do kształtowania jego przyszłości.
FAQ
Blog
Apache Hadoop to jeden z kluczowych elementów w świecie Big Data. Jest to framework open source, który umożliwia przechowywanie i przetwarzanie ogromnych ilości danych, niezależnie od ich rodzaju i formatu. Dzięki Hadoopowi możliwe jest wykorzystanie klastrów komputerowych do równoległego przetwarzania danych, co przyspiesza analizę i generowanie wartościowych informacji. Bez Hadoopa wiele projektów związanych z Big Data nie byłoby możliwe do zrealizowania.
Rozwój technologii informacyjnych i gwałtownie rosnąca ilość danych generowanych każdego dnia stawia przed naukowcami i analitykami nowe wyzwania. Jednym z kluczowych elementów analizy danych jest grupowanie, czyli algorytmy, które pozwalają na skategoryzowanie danych i odkrycie ukrytych wzorców. W tym artykule przyjrzymy się bliżej temu aspektowi analizy danych, odkrywając nowe horyzonty tej fascynującej dziedziny.
Zmierzając ku coraz bardziej złożonym obliczeniom naukowym, pracownicy branży IT cenią sobie możliwości, jakie daje im Google Colab. Jak darmowy asystent do obliczeń w chmurze, Colab nie tylko upraszcza życie, ale także pozwala na efektywne wykorzystanie mocy obliczeniowej udostępnianej w chmurze. Zachęcamy do zerknięcia pod maskę Colab i zapoznania się z jego kluczowymi funkcjami.
Zarządzanie wydajnością bazy danych to niezmiennie gorący temat. Jednym z technik, które znacznie przyspieszają jej działanie, jest Batch Fetching. Jest to metoda grupowania zapytań, która pozwala na znaczące optymalizacje. Zapraszam do lektury, w której podejmiemy próbę zrozumienia jak to działa i jak możemy z tego skorzystać.
DuckDB to analityczna baza danych, która działa wewnątrz aplikacji, bez serwera i bez administratora. Wyjaśniamy, skąd bierze się jej szybkość, jak czyta pliki CSV i Parquet bez importu, gdzie sprawdza się w firmie, czego nie zastąpi i co zmienia zapowiadany tryb serwera w wersji 2.0.
Azure Databricks to innowacyjna usługa analityczna w chmurze, której zadaniem jest umożliwienie przetwarzania dużych zbiorów danych w czasie rzeczywistym. Wykorzystując potencjał technologii Spark, stanowi potężne narzędzie do analizy Big Data. Poznajmy Azure Databricks: jego definicję, możliwości, a także powody, dla których warto zapoznać się z tą technologią.