ElectricSQL - synchronizacja danych w czasie rzeczywistym. Jak działa i do czego służy?
ElectricSQL przesyła zmiany z bazy PostgreSQL prosto na ekrany użytkowników, bez ręcznego odświeżania i bez budowania własnej warstwy powiadomień. Tłumaczymy, jak działa ten silnik synchronizacji, jakie ma ograniczenia i w jakich projektach lepiej wybrać coś prostszego.
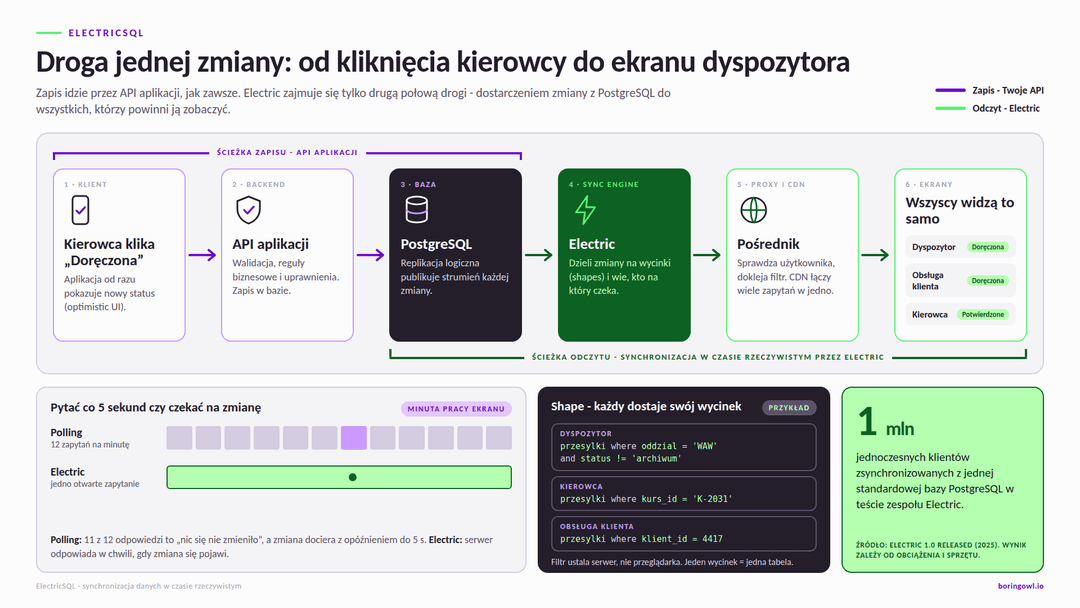
Dyspozytor w firmie kurierskiej ma na ekranie czterdzieści przesyłek. Jedna właśnie zmieniła status na „doręczona”, druga utknęła z kierowcą w korku, a ktoś z obsługi klienta przepisał trzecią na inny kurs. Dyspozytor dowie się o tym, kiedy odświeży stronę. Albo kiedy zadzwoni telefon. ElectricSQL rozwiązuje ten problem u źródła: zapewnia synchronizację danych w czasie rzeczywistym z bazy PostgreSQL do aplikacji, więc zmiana zapisana w bazie po chwili pojawia się na każdym ekranie, który jej potrzebuje. Aplikacji, w których kilka osób pracuje jednocześnie na tych samych danych, jest więcej, niż się wydaje. Grafiki zmian, rezerwacje, stany magazynowe, lejki sprzedażowe w CRM. Zwykle ich twórcy wybierają jedną z dwóch dróg. Aplikacja co kilka sekund pyta serwer, czy coś się zmieniło, albo zespół buduje własny system powiadomień. Pierwsza droga obciąża serwer, a dane i tak docierają z opóźnieniem. Druga działa dobrze do momentu, w którym ktoś zapyta, co się stanie, gdy użytkownik na minutę straci zasięg.
Odświeżanie, zapytania co kilka sekund i WebSockety
Najprostszy sposób na „świeże” dane to polling, czyli regularne odpytywanie serwera w stałych odstępach. Popularne biblioteki, takie jak React Query do pracy z danymi asynchronicznymi, robią to niemal automatycznie. Przy kilku użytkownikach problemu nie widać. Przy kilkuset, z których każdy co pięć sekund pobiera listę zamówień, baza danych zaczyna odpowiadać na tysiące zapytań na minutę. Większość z nich zwraca to samo co poprzednio. Drugi sposób to stałe połączenie między przeglądarką a serwerem, najczęściej przez WebSocket, czyli kanał, którym serwer może sam wysłać wiadomość, zamiast czekać na pytanie. To szybkie i sprawdzone rozwiązanie. Kłopot w tym, że WebSocket jest tylko rurą. Zespół musi sam zdecydować, co nią przesyłać, jak po zerwaniu połączenia odtworzyć zmiany, które w tym czasie przepadły, i jak pilnować, żeby użytkownik nie dostał danych, których nie powinien widzieć. W systemach złożonych z wielu usług dochodzi do tego koordynacja między nimi, o czym więcej przy implementacji WebSocketów w mikroserwisach.
W praktyce każdy ekran „na żywo” dostaje wtedy własną, trochę inną logikę synchronizacji. Po roku nikt nie pamięta, który działa jak.
Jak ElectricSQL synchronizuje dane w czasie rzeczywistym
ElectricSQL, dziś rozwijany pod nazwą Electric, to silnik synchronizacji (sync engine) stojący między bazą PostgreSQL a aplikacjami. Nie zastępuje bazy ani backendu. Jego zadanie jest wąskie: wiedzieć, co zmieniło się w bazie, i dostarczyć te zmiany do klientów, którzy ich potrzebują.
Źródłem informacji jest replikacja logiczna, czyli wbudowany w PostgreSQL mechanizm, który publikuje strumień wszystkich zapisów w bazie. Z tego mechanizmu korzystają zwykle zapasowe kopie bazy. Electric podłącza się do niego jak jeszcze jedna kopia, ale zamiast przechowywać dane, dzieli zmiany na porcje dla konkretnych ekranów i klientów. Aplikacja nie musi o nic pytać co pięć sekund. Nie trzeba też dopisywać do kodu powiadomień przy każdym zapisie. Klient pobiera dane zwykłymi zapytaniami HTTP. Najpierw dostaje aktualny stan, a potem utrzymuje otwarte zapytanie, które serwer zamyka dopiero wtedy, gdy ma coś nowego. Brzmi skromnie. Ma jednak ważną konsekwencję: odpowiedzi da się buforować w sieci dostarczania treści (CDN), tak samo jak obrazki czy pliki strony. Jeśli sto osób ogląda tę samą listę, CDN może zebrać ich zapytania w jedno, a Electric obsługuje jedno połączenie zamiast stu.
Na tym opiera się deklarowana skala. Przy premierze wersji 1.0 zespół Electric podał, że w testach zsynchronizował dane do miliona jednoczesnych klientów, korzystając z jednej standardowej bazy PostgreSQL (Electric 1.0 released). W oficjalnych benchmarkach propagacja zmiany przy prostych filtrach zajmowała około 6 ms. Sami autorzy zastrzegają, że wyniki zależą od obciążenia, wersji i sprzętu, więc przed decyzją trzeba je sprawdzić na własnych danych.
Druga wersja projektu
Obecny Electric to w dużej mierze nowy produkt. Pierwsza wersja z 2023 roku była ambitną platformą local-first: synchronizowała dane w obie strony do lokalnej bazy SQLite wbudowanej w aplikację i sama rozwiązywała konflikty zapisów. W 2024 roku zespół przebudował projekt od zera. W artykule o zmianie kierunku przyznał, że złożoność całego stosu dawała szerokie pole do błędów, przez co zamiast nad wydajnością i stabilnością pracował nad problemami z konfiguracją i narzędziami.
Nowa wersja robi mniej, ale robi to niezawodnie. Wydanie 1.0 z marca 2025 roku zespół opisał jako gotowe do produkcyjnych, krytycznych zastosowań, ze stabilnym API. Projekt jest open source na licencji Apache 2.0. Z Electric korzysta m.in. Trigger.dev, który zbudował na nim funkcję śledzenia zadań na żywo. Dla firmy, która wybiera technologię na lata, taka historia jest dobrym sygnałem. Twórcy zrezygnowali z efektownej obietnicy na rzecz czegoś, co działa.
Shapes, czyli kto dostaje które dane
Podstawowym pojęciem w Electric jest shape, po polsku najprościej „wycinek danych”. Shape to definicja tego, co ma trafić do klienta: jedna tabela, opcjonalny filtr i opcjonalna lista kolumn. Dla naszego dyspozytora mógłby to być wycinek „przesyłki z oddziału Warszawa, które nie są jeszcze zarchiwizowane”. Kierowca dostałby inny: tylko swoje przesyłki z dzisiejszego kursu. Takie podejście ma swoje ograniczenia i lepiej znać je przed projektem. Wycinek dotyczy zawsze jednej tabeli. Da się filtrować po danych z innych tabel, ale same powiązane dane, na przykład adres klienta przy przesyłce, trzeba pobrać osobnym wycinkiem i połączyć w aplikacji. Definicji wycinka nie można zmienić w trakcie subskrypcji. W filtrach nie wolno też używać funkcji, których wynik zmienia się w czasie, takich jak bieżąca data. Filtr „przesyłki z ostatnich 24 godzin” trzeba więc zaprojektować inaczej, na przykład przez kolumnę z datą kursu.
Z tych ograniczeń wynika praktyczny wniosek. Model danych ma przy Electric większe znaczenie niż zwykle. Jeśli tabela jest zaprojektowana tak, że naturalnie dzieli się na porcje dla użytkowników, synchronizacja jest prosta. Jeśli każdy ekran wymaga pięciu złączeń tabel, zacznie się walka z narzędziem.
Uprawnień pilnuje aplikacja, nie Electric
Dokumentacja Electric stawia sprawę jasno: bez zabezpieczeń silnik udostępnia każdemu klientowi, który się z nim połączy, wszystkie dane, do których ma dostęp jego użytkownik w bazie (Electric - Security). Dlatego Electric nigdy nie powinien być wystawiony bezpośrednio do internetu. Zapytania klientów przechodzą przez warstwę pośrednią w aplikacji, która sprawdza, kim jest użytkownik, i sama dokleja do wycinka odpowiedni filtr. W aplikacji na Next.js tę rolę pełni zwykły endpoint w backendzie, korzystający z tego samego logowania co reszta systemu, na przykład z uwierzytelniania przez NextAuth.js. Kierowca, który spróbuje podmienić filtr w przeglądarce, i tak dostanie tylko swoje przesyłki, bo filtr ustala serwer, nie klient.
Electric czyta dane, zapis zostaje po stronie API
Electric synchronizuje dane w jedną stronę: z bazy do klienta. To świadoma decyzja, a nie brak. Zapisy nadal idą przez API aplikacji, gdzie działa walidacja, reguły biznesowe i kontrola uprawnień. Gdy API zapisze zmianę w PostgreSQL, Electric wyłapie ją z replikacji i roześle do wszystkich zainteresowanych ekranów, również do tego, z którego zmiana wyszła. Pozostaje pytanie, co użytkownik widzi w ułamku sekundy między kliknięciem a potwierdzeniem z serwera. Dokumentacja Electric opisuje kilka wzorców, od najprostszego do najcięższego. Najprostszy to zwykły zapis z krótkim wskaźnikiem ładowania. Kolejny to optymistyczny interfejs (optimistic UI), który od razu pokazuje zmianę jako wykonaną i cofa ją, jeśli serwer odmówi. Na drugim końcu jest pełna praca offline z lokalną bazą w przeglądarce.
Po stronie klienta zespół Electric współtworzy bibliotekę TanStack DB, czyli lokalny magazyn danych, który łączy dane z synchronizacji z optymistycznymi zmianami użytkownika. Od wersji 0.6 z marca 2026 roku potrafi też przechowywać dane między uruchomieniami aplikacji (Electric blog). Najcięższy wariant opiera się na PGlite, czyli pełnym PostgreSQL działającym w przeglądarce. Daje prawdziwy tryb offline, ale oznacza sporo dodatkowej złożoności.
Większości aplikacji biznesowych wystarcza środek tej skali. Optymistyczny interfejs dla prostych zmian i zwykły zapis tam, gdzie trzeba poczekać na decyzję serwera, na przykład przy płatności.
Gdzie synchronizacja z PostgreSQL ma największy sens
Electric najlepiej sprawdza się tam, gdzie wiele osób jednocześnie patrzy na te same, często zmieniające się dane, a spóźniona informacja kosztuje czas lub pieniądze. Z naszej perspektywy są to przede wszystkim:
panele operacyjne w logistyce i transporcie, gdzie dyspozytorzy i kierowcy pracują na tych samych zleceniach,
CRM-y i narzędzia sprzedażowe, w których handlowiec widzi od razu, że lead przejął kolega,
panele z bieżącymi wskaźnikami, na przykład stanem zamówień lub zgłoszeń,
narzędzia do wspólnej pracy nad dokumentami, zadaniami czy planami,
aplikacje z agentami AI, w których użytkownik chce na bieżąco widzieć, co agent właśnie robi.
Ostatni punkt nie jest przypadkowy. Electric coraz mocniej pozycjonuje się jako infrastruktura dla systemów, w których ludzie i agenty AI pracują na wspólnych danych, i poza synchronizacją z PostgreSQL rozwija osobne strumienie danych przesyłane przez HTTP. Dla firmy, która planuje produkt z asystentem AI, to rozsądny kierunek do obserwowania. Przy panelach dobrze pamiętać, że dane na żywo to połowa sukcesu. Druga połowa to czytelny projekt dashboardu. Liczba, która zmienia się co sekundę, rozprasza bardziej, niż pomaga, jeśli nikt nie wie, co z nią zrobić.
Electric nie jest domyślnym wyborem dla każdej aplikacji. Jeśli dane zmieniają się kilka razy dziennie, na przykład oferta w katalogu albo treści na stronie, wystarczy dobrze ustawione buforowanie i odświeżanie po stronie serwera. W Next.js to kwestia wyboru między generowaniem statycznym a renderowaniem na serwerze, a nie osobnego silnika synchronizacji. Inaczej wygląda sytuacja, gdy projekt startuje od zera i nie ma jeszcze bazy danych. Wtedy warto porównać Electric z platformami, które łączą bazę, backend i synchronizację w jednym produkcie, takimi jak Firebase, Supabase z modułem Realtime czy Convex. Dają szybszy start, ale mocniej wiążą produkt z jednym dostawcą. Convex, backend dla aplikacji czasu rzeczywistego, idzie w tym najdalej: logikę serwera pisze się tam w TypeScripcie, a interfejs aktualizuje się sam po każdej zmianie danych. Electric ma przewagę tam, gdzie PostgreSQL już działa, jest w nim cała logika firmy i nikt nie chce jej przenosić. Trzeci przypadek to praca w terenie bez zasięgu, na przykład serwisantów czy inspektorów budowlanych. Aplikacja musi wtedy przyjmować zapisy offline i rozwiązywać konflikty, gdy dwie osoby zmienią ten sam rekord. Sam Electric tego nie robi. Da się to zbudować na PGlite albo innym lokalnym magazynie, ale to osobny, niemały projekt. Czasem prostsza okazuje się aplikacja PWA z trybem offline i jasną regułą, która zmiana wygrywa.
Wreszcie skala zespołu. Electric to dodatkowa usługa do utrzymania, napisana w Elixirze, z własnymi wymaganiami co do dysku i monitoringu. Jeśli jedyną funkcją „na żywo” w aplikacji jest licznik nieprzeczytanych wiadomości, zwykły WebSocket będzie tańszy w utrzymaniu.
Co trzeba przygotować przed wdrożeniem Electric
Wymagania są krótkie. Potrzebna jest baza PostgreSQL w wersji 14 lub nowszej z włączoną replikacją logiczną oraz użytkownik bazy z uprawnieniem do replikacji. Według dokumentacji Electric działa z popularnymi usługami bazodanowymi, m.in. Supabase, Neon, AWS RDS i Aurora oraz Google Cloud SQL (Electric - Deployment). U części dostawców replikację logiczną trzeba włączyć ręcznie w ustawieniach, co bywa pierwszym zaskoczeniem. Sam silnik to usługa uruchamiana jako kontener Docker. Najbardziej zależy mu na szybkim dysku, bo tam przechowuje przygotowane wycinki danych, a w dalszej kolejności na pamięci i procesorze. Przed nim powinien stać serwer pośredniczący albo CDN, który buforuje odpowiedzi i pilnuje dostępu. Ułożenie tego w całość to zadanie z zakresu architektury i DevOps. Kto nie chce utrzymywać kolejnej usługi, może skorzystać z Electric Cloud, czyli wersji hostowanej przez twórców. Po stronie aplikacji dochodzi klient w TypeScripcie albo TanStack DB, endpoint pośredniczący z kontrolą uprawnień i przemyślenie, które ekrany faktycznie potrzebują danych na żywo. Zwykle jest ich mniej, niż zakłada pierwsza lista życzeń.
FAQ
FAQ - Najczęściej zadawane pytania o ElectricSQL
Tak, ElectricSQL jest projektem open source udostępnionym na licencji Apache 2.0, więc można go bezpłatnie używać także w projektach komercyjnych. Licencja pozwala uruchomić silnik na własnych serwerach, modyfikować kod i włączyć go do produktu bez opłat dla twórców. Płaci się za to, na czym Electric działa: serwer lub kontener z szybkim dyskiem, bazę PostgreSQL, ruch sieciowy i ewentualnie CDN. Alternatywą jest Electric Cloud, czyli wersja utrzymywana przez twórców, rozliczana według ich cennika. Wybór między samodzielnym hostingiem a chmurą zależy głównie od tego, czy firma ma zespół, który przejmie monitoring i aktualizacje kolejnej usługi, oraz od wymagań dotyczących miejsca przechowywania danych.
Działający prototyp jednego ekranu z danymi na żywo można zwykle przygotować w kilka dni, a pełne wdrożenie produkcyjne zajmuje od kilku tygodni do kilku miesięcy. Pierwsze dni to włączenie replikacji logicznej w bazie, uruchomienie silnika i sprawdzenie, jak zachowuje się wybrany widok. Dalsze tygodnie pochłania to, czego prototyp nie pokazuje: kontrola dostępu dla różnych ról użytkowników, obsługa zapisu z natychmiastową reakcją interfejsu, monitoring, testy przy realnej liczbie użytkowników i konfiguracja CDN. Harmonogram wydłuża się, gdy model danych trzeba dostosować do ograniczeń silnika, gdy baza jest u dostawcy wymagającego zmian w konfiguracji albo gdy aplikacja ma pracować offline. Najszybciej idzie w projektach, w których PostgreSQL już działa, a zakres ogranicza się do kilku widoków.
Tak, ElectricSQL działa z bazą PostgreSQL hostowaną w Supabase, podobnie jak z Neon, AWS RDS i Aurora czy Google Cloud SQL. Warunkiem jest dostęp do replikacji logicznej i użytkownik bazy z uprawnieniem do replikacji, a Supabase oba te elementy udostępnia. W praktyce Electric uruchamia się jako osobną usługę, która łączy się z bazą Supabase, a aplikacja nadal korzysta z pozostałych funkcji platformy, takich jak logowanie czy przechowywanie plików. Takie połączenie ma sens, gdy wbudowany moduł Realtime nie wystarcza, na przykład przy dużej liczbie użytkowników oglądających te same dane albo gdy potrzebny jest pełny początkowy stan danych i dokładne śledzenie zmian po utracie połączenia. Przed wdrożeniem trzeba sprawdzić limity połączeń replikacyjnych w wybranym planie Supabase.
ElectricSQL dostarcza klientowi kompletny, spójny wycinek danych i utrzymuje go aktualnym, a Supabase Realtime przede wszystkim powiadamia o pojedynczych zmianach w bazie. Przy Supabase Realtime aplikacja zwykle najpierw pobiera dane zwykłym zapytaniem, a potem nasłuchuje zdarzeń i sama nanosi je na to, co już ma, co wymaga ostrożności przy zerwanym połączeniu. Electric zaczyna od stanu początkowego, a następnie przesyła zmiany w kolejności, z informacją, od którego miejsca klient ma kontynuować po przerwie. Druga różnica to sposób dostarczania: Electric korzysta ze zwykłego HTTP, więc odpowiedzi mogą być buforowane w CDN i współdzielone przez wielu użytkowników, co pomaga przy dużej skali. Supabase Realtime jest wygodniejszy w małych projektach, w których wszystko i tak działa na tej platformie, a Electric sprawdza się lepiej przy wielu odbiorcach tych samych danych i niezależności od jednego dostawcy.
Tak, ElectricSQL ma oficjalnego klienta w TypeScripcie i integrację z React, dzięki czemu dobrze pasuje do aplikacji budowanych w Next.js. Komponent React subskrybuje wybrany wycinek danych i odświeża się automatycznie, gdy w bazie zajdzie zmiana, bez ręcznego odpytywania serwera. W Next.js zapytania z przeglądarki kieruje się do własnego endpointu w backendzie, który sprawdza sesję użytkownika, dodaje filtr ograniczający dane do tego, co wolno mu zobaczyć, i dopiero wtedy przekazuje zapytanie do Electric. Coraz częściej zamiast bezpośredniego klienta stosuje się TanStack DB, który łączy dane z synchronizacji z optymistycznymi zmianami użytkownika i pozwala wykonywać na nich zapytania po stronie przeglądarki. Wybór zależy od tego, jak rozbudowana jest logika interfejsu i czy aplikacja ma zapamiętywać dane między uruchomieniami.
Tak, ale wymaga to dodatkowej warstwy po stronie aplikacji, bo sam silnik Electric odpowiada tylko za dostarczanie danych z serwera. Najprostszy wariant to przechowywanie ostatnio zsynchronizowanych danych w przeglądarce lub na urządzeniu, dzięki czemu użytkownik bez zasięgu nadal widzi ostatni znany stan, a po powrocie połączenia aplikacja pobiera tylko brakujące zmiany. Bardziej zaawansowany wariant pozwala także zapisywać zmiany offline: trafiają one do lokalnej kolejki i są wysyłane do API, gdy sieć wróci. Najdalej idzie PGlite, czyli pełny PostgreSQL uruchomiony w przeglądarce, który umożliwia pracę na lokalnej bazie. Im więcej zapisów offline, tym ważniejsze stają się reguły rozwiązywania konfliktów, na przykład gdy dwie osoby zmienią ten sam rekord bez połączenia. To one zwykle decydują o nakładzie pracy.
Tak, ElectricSQL można uruchomić na własnej infrastrukturze, ponieważ jest dostępny jako obraz Docker i nie wymaga usług chmurowych twórców. Silnik działa na dowolnej platformie obsługującej kontenery, na przykład w AWS, Google Cloud, DigitalOcean, na Fly.io czy na własnych serwerach firmy. Najważniejszy jest szybki, trwały dysk, na którym Electric przechowuje przygotowane dane dla klientów, a w dalszej kolejności pamięć i procesor. Przed silnikiem stawia się serwer pośredniczący, taki jak Nginx lub Caddy, albo CDN, który buforuje odpowiedzi i ogranicza dostęp z zewnątrz. Samodzielny hosting daje pełną kontrolę nad lokalizacją danych i kosztami, ale oznacza odpowiedzialność za aktualizacje, kopie zapasowe konfiguracji i monitoring. Firmy bez zespołu utrzymaniowego częściej wybierają Electric Cloud.
Czy kiedykolwiek zmagałeś się z zarządzaniem asynchronicznymi danymi w swojej aplikacji React? Jeżeli tak, to React Query może być dla Ciebie idealnym rozwiązaniem. W tym artykule przedstawię Ci kluczowe możliwości tego potężnego narzędzia, które może zrewolucjonizować Twój sposób obsługi danych z API.
Architektura mikroserwisów zyskała ogromną popularność, dostarczając wydajne rozwiązania dla złożonych aplikacji webowych. Jednym z kluczowych aspektów jej realizacji jest komunikacja w czasie rzeczywistym, do której doskonale nadają się WebSockets. W naszym przewodniku krok po kroku zapoznasz się z procesem implementacji WebSockets w takim środowisku.
CDN, czyli sieć dostarczania treści, to system, który pozwala na przyspieszenie i zwiększenie niezawodności dostarczania treści na stronie internetowej. Działa on na zasadzie rozproszenia serwerów, które przechowują kopie treści strony w różnych lokalizacjach geograficznych.
Autoryzacja użytkowników to kluczowe zagadnienie w każdej aplikacji webowej. W artykule tym przedstawię, jak skutecznie wykorzystać NextAuth.js - bibliotekę do obsługi autoryzacji w aplikacjach Next.js, która znaną jest z elastyczności, bezpieczeństwa, a także łatwości implementacji.
W świecie, w którym użytkownicy oczekują natychmiastowych reakcji i płynnej interakcji, tworzenie aplikacji w czasie rzeczywistym staje się nie tylko wyzwaniem, ale i koniecznością. Convex to nowoczesna platforma backendowa, która upraszcza ten proces, łącząc synchronizację danych, logikę biznesową i skalowalność w jednym ekosystemie. Dzięki niej deweloperzy mogą budować interaktywne aplikacje bez konieczności konfigurowania skomplikowanej infrastruktury czy zarządzania WebSocketami.
Generowanie statyczne (SSG) oraz generowanie na serwerze (SSR) są dwoma różnymi podejściami do przetwarzania stron w frameworku Next.js. SSG jest idealny do stron o małej zmienności, gdzie cała zawartość można wygenerować w momencie budowania projektu. Z kolei SSA jest preferowany, gdy strona zawiera elementy dynamiczne, które muszą być generowane na bieżąco. Wybór między nimi zależy od specyfiki projektu i wymagań, ale umiejętne stosowanie obu strategii pozwala na optymalizację wydajności i…