OpenObserve jako alternatywa dla Datadog i Elasticsearch
OpenObserve to otwartoźródłowa platforma do logów, metryk i śladów, która przechowuje dane w tanim magazynie obiektowym zamiast na drogich dyskach. Rozkładamy koszt monitoringu na trzy rachunki - abonament, serwery i ludzi - i pokazujemy, gdzie OpenObserve zmienia każdy z nich, a gdzie nie zmienia nic.
Logi rzadko trafiają na zebranie zarządu. Do momentu, w którym ktoś zauważa, że rachunek za ich przechowywanie jest wyższy niż za serwery, na których działa sama aplikacja. Wtedy pada pytanie, czy da się taniej. OpenObserve jako alternatywa dla Datadog i Elasticsearch to jedna z odpowiedzi, które coraz częściej pojawiają się w takich rozmowach.
Datadog i Elasticsearch to dwa różne światy. Pierwszy to usługa w chmurze, za którą płaci się co miesiąc według tego, ile się monitoruje. Drugi to silnik, który firma stawia na własnych serwerach i sama utrzymuje. OpenObserve próbuje zastąpić oba, z innego powodu w każdym przypadku.
OpenObserve jako alternatywa dla Datadog i Elasticsearch - co to jest
OpenObserve to platforma do obserwowalności (observability), czyli zbierania i przeglądania danych o tym, co dzieje się w działającej aplikacji. Obsługuje trzy podstawowe rodzaje takich danych: logi, czyli zapisy zdarzeń, metryki, czyli liczby mierzone w czasie, oraz ślady żądań, które pokazują drogę jednego kliknięcia przez wiele usług. Ten ostatni temat dobrze wyjaśnia wpis o distributed tracing. Do tego dochodzą dashboardy, alerty i monitorowanie doświadczeń użytkowników w przeglądarce.
Projekt jest napisany w języku Rust i udostępniony jako open source. Według repozytorium na GitHubie ma około 21 tys. gwiazdek. Dane można przeszukiwać w SQL, a metryki w PromQL, czyli języku zapytań znanym z Prometheusa. Zespół, który zna te narzędzia, nie musi uczyć się nowego, zamkniętego języka. Najważniejsza różnica leży jednak niżej, w sposobie przechowywania danych. Od niej zależy większość kosztów.
Rachunek pierwszy: abonament i licencja
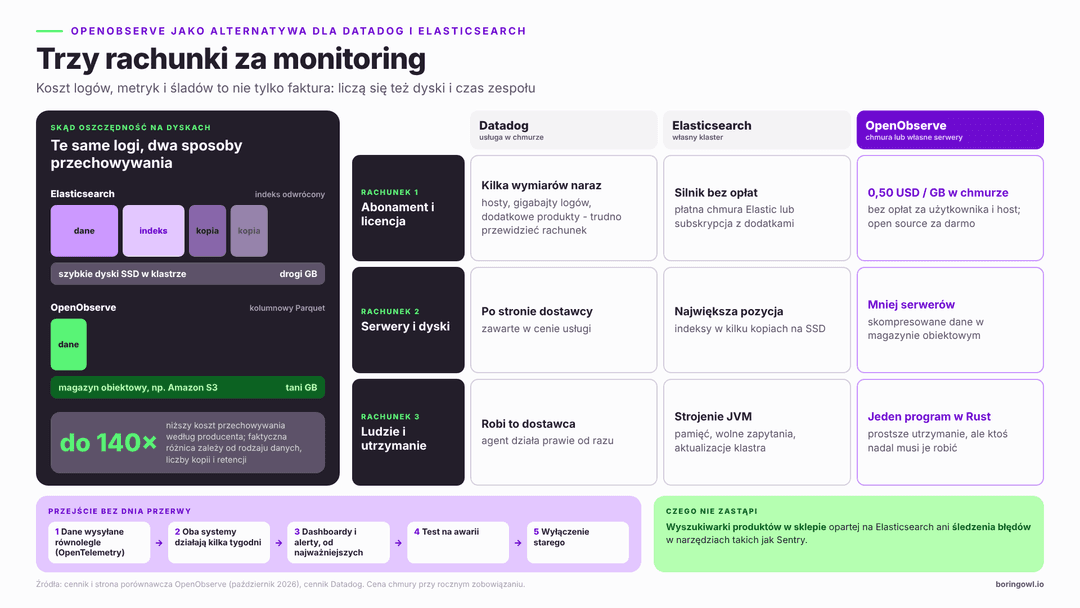
Datadog rozlicza się w kilku wymiarach jednocześnie: od monitorowanych hostów, od ilości przyjmowanych i przechowywanych logów, od dodatkowych produktów. Cennik Datadog jest szczegółowy, ale przy rosnącej infrastrukturze trudno przewidzieć, ile wyniesie rachunek za pół roku. Każdy nowy serwer i każda nowa usługa coś dokładają. OpenObserve ma prostszy model. Według cennika OpenObserve (stan na październik 2026) wersja w chmurze kosztuje w planie Professional 0,50 USD za każdy przyjęty gigabajt danych przy rocznym zobowiązaniu oraz 0,01 USD za każdy gigabajt przeszukany zapytaniami. Nie ma opłat za użytkownika ani za host. Logi i ślady są przechowywane 30 dni, metryki 15 miesięcy, a dłuższa retencja kosztuje 0,02 USD za gigabajt za każde dodatkowe 30 dni.
Dla porównania orientacyjnego: firma, która wysyła 100 GB logów dziennie, czyli około 3000 GB miesięcznie, zapłaci w chmurze OpenObserve za samo przyjęcie danych około 1500 USD miesięcznie, plus opłaty za zapytania. Gdyby wybrała wersję na własnych serwerach, rachunek za licencję spada do zera. Wersja open source jest darmowa bez limitu, a wersja Enterprise z logowaniem SSO i rozbudowanymi uprawnieniami jest bezpłatna do 50 GB dziennie.
Przy Elasticsearch ten rachunek wygląda inaczej. Sam silnik można uruchomić bez opłat, a płatna jest wersja chmurowa Elastic albo subskrypcja z dodatkowymi funkcjami. Główny koszt Elasticsearch leży gdzie indziej. W drugim rachunku.
Elasticsearch, popularny element zestawu ELK, zbudowano przede wszystkim do szybkiego wyszukiwania tekstu. Robi to dzięki indeksowi odwróconemu, czyli spisowi, który dla każdego słowa pamięta, w których dokumentach występuje. To działa świetnie, ale ma cenę: indeks bywa tak duży jak same dane, a dla bezpieczeństwa przechowuje się go w kilku kopiach na szybkich dyskach SSD. Klaster Elasticsearch z logami z kilku miesięcy potrafi zajmować wiele terabajtów drogiej przestrzeni.
OpenObserve robi to inaczej. Zapisuje dane w formacie Parquet, który przechowuje je kolumnami i bardzo dobrze kompresuje powtarzalne wartości, a w logach powtarzalności jest dużo. Pliki trafiają do magazynu obiektowego, takiego jak Amazon S3 lub jego odpowiednik w innej chmurze, gdzie gigabajt kosztuje ułamek ceny dysku SSD w serwerze. Producent podaje, że koszty przechowywania mogą być nawet 140 razy niższe niż w Elasticsearch. Na stronie porównawczej OpenObserve sam zastrzega jednak, że faktyczna oszczędność zależy od rodzaju danych, liczby kopii i długości przechowywania. Traktujemy to jako górną granicę, a nie obietnicę. Nawet kilkukrotna różnica przy kilkudziesięciu terabajtach logów zmienia budżet infrastruktury.
Dla firm, które działają w chmurze AWS, oznacza to też prostszą architekturę. Część z nich trzyma dziś logi w Amazon CloudWatch, którego koszt również rośnie wraz z ilością danych. Zamiast klastra z wieloma węzłami i dyskami trzeba utrzymać mniejszą liczbę serwerów obliczeniowych, a dane leżą w S3 z jego trwałością i cyklem życia, na przykład automatycznym przenoszeniem starszych logów do tańszej klasy przechowywania.
140 razy taniej - górna granica, nie gwarancja
Producent podaje tę różnicę na własnej stronie porównawczej i sam zaznacza, że faktyczna oszczędność zależy od rodzaju danych, liczby replik i czasu retencji. Nawet kilkukrotna różnica przy kilkudziesięciu terabajtach jest wyraźna w budżecie infrastruktury. Zanim wybierzesz narzędzie, policz własne liczby: ile GB dziennie, jak długa retencja, ile kosztuje teraz storage.
Rachunek trzeci: ludzie i utrzymanie
Ten rachunek nie pojawia się na fakturze, a często jest najwyższy. Elasticsearch działa na maszynie wirtualnej Javy, która wymaga strojenia pamięci. Zespół, który go utrzymuje, zna dobrze nocne alerty o przepełnionej pamięci, wolnych zapytaniach i węzłach, które wypadły z klastra. Do tego dochodzą aktualizacje wersji, które w dużym klastrze trzeba planować jak osobny projekt. OpenObserve jest pojedynczym programem, który można uruchomić w kilka minut w kontenerze Docker, a w środowisku produkcyjnym w klastrze Kubernetes w trybie wysokiej dostępności, instalowany na przykład za pomocą pakietów Helm. Rust nie ma problemu z pauzami odśmiecania pamięci, który zna każdy, kto utrzymywał Elasticsearch. To realnie zmniejsza liczbę rzeczy, które mogą się zepsuć. Nie oznacza to, że utrzymanie znika. Ktoś musi aktualizować system, pilnować retencji, konfigurować alerty i odpowiadać, gdy coś przestanie zbierać dane. W większych firmach to zadanie zespołu SRE, odpowiedzialnego za niezawodność systemów. W porównaniu z Datadogiem, gdzie to wszystko robi dostawca, wersja na własnych serwerach przenosi część kosztu z faktury na zespół. Taką pracę wykonuje zespół od DevOps i architektury, wewnętrzny albo zewnętrzny.
Jest jeszcze licencja. Wersja open source OpenObserve jest udostępniona na licencji AGPL-3.0. Przy używaniu narzędzia wewnętrznie do monitorowania własnych aplikacji nie rodzi to żadnych obowiązków. Znaczenie ma dopiero wtedy, gdy firma chce zmodyfikować OpenObserve i udostępniać je jako usługę innym, bo wtedy musi opublikować swoje zmiany. Dla większości firm to szczegół, ale przed wdrożeniem dobrze, żeby ktoś go sprawdził.
AGPL-3.0: wewnętrzne użycie jest wolne, odsprzedaż modyfikacji - nie
Używanie OpenObserve do monitorowania własnych aplikacji nie wymaga ujawniania kodu ani żadnych opłat. AGPL wchodzi w grę dopiero wtedy, gdy firma modyfikuje kod i udostępnia narzędzie jako usługę innym. Dla zdecydowanej większości wdrożeń to bez znaczenia - ale warto, żeby dział prawny lub ktoś techniczny to potwierdził przed startem.
Czego OpenObserve nie zastąpi
Elasticsearch jest używany do dwóch zupełnie różnych rzeczy i to łatwo przeoczyć. Pierwsza to logi, i tu OpenObserve jest rozsądną alternatywą. Druga to wyszukiwarka w produkcie, na przykład wyszukiwanie produktów w sklepie internetowym, z podpowiedziami, literówkami i trafnością wyników. Tu OpenObserve nie konkuruje i producent mówi to wprost: w ogólnym wyszukiwaniu dokumentów indeks odwrócony Elasticsearch pozostaje najlepszy w swojej klasie. Jeśli sklep korzysta z Elasticsearch jako wyszukiwarki, ta część zostaje bez zmian. Po stronie Datadoga różnica dotyczy dojrzałości i zasięgu. Datadog ma setki gotowych integracji, rozbudowane funkcje bezpieczeństwa i lata dopracowywania szczegółów. Podobnie jak New Relic czy Splunk, sprzedaje wygodę: instalujesz agenta i większość rzeczy działa od razu. W OpenObserve część tej pracy trzeba wykonać samemu, zwłaszcza przy nietypowych źródłach danych.
Nie zastąpi też narzędzi wyspecjalizowanych. Śledzenie błędów aplikacji z grupowaniem wyjątków i informacją o tym, którego użytkownika dotyczą, lepiej robi Sentry. Wiele zespołów łączy oba narzędzia i nie ma w tym nic złego.
Zmiana narzędzia do monitoringu ma jedną zasadę: przez cały czas ktoś musi widzieć, co się dzieje w produkcji. Dlatego nie wyłącza się starego systemu, dopóki nowy nie udowodni, że działa. W praktyce przejście wygląda tak:
wysyłanie danych przez OpenTelemetry, otwarty standard zbierania logów, metryk i śladów, albo przez kolektory takie jak Fluent Bit i Logstash, w których OpenObserve jest zgodne z API Elasticsearch, więc wystarczy dodać drugi adres docelowy,
równoległe działanie obu systemów przez kilka tygodni, z tymi samymi danymi trafiającymi w dwa miejsca,
odtworzenie najważniejszych dashboardów i alertów, zaczynając od tych, które budzą ludzi w nocy,
sprawdzenie alertów na prawdziwym incydencie albo kontrolowanej awarii w środowisku testowym,
wyłączenie starego systemu dopiero wtedy, gdy zespół przez dłuższy czas pracuje tylko na nowym.
Najwięcej czasu zajmuje zwykle trzeci krok. Dashboardy i alerty w Datadogu czy Kibanie powstawały latami i nikt nie pamięta, po co jest połowa z nich. To dobry moment na porządki, podobny do spłaty długu technologicznego: przenieść tylko to, z czego ktoś naprawdę korzysta.
Wizualizację dla zespołów przyzwyczajonych do Grafany można zostawić bez zmian, bo Grafana łączy się z wieloma źródłami danych. Alerty z OpenObserve mogą trafiać tam, gdzie zespół i tak pracuje, na przykład na Slacka.
FAQ
FAQ - Najczęściej zadawane pytania o OpenObserve
Tak, OpenObserve w wersji open source jest darmowe i nie ma limitu ilości przyjmowanych danych. Kod jest udostępniony na licencji AGPL-3.0, a firma płaci wtedy tylko za serwery, magazyn danych i czas osób, które system utrzymują. Producent oferuje też bezpłatną wersję Enterprise do instalacji na własnych serwerach, z logowaniem SSO i rozbudowanymi uprawnieniami, do 50 GB danych dziennie. Wersja w chmurze jest płatna i według cennika z października 2026 roku kosztuje w planie Professional 0,50 USD za gigabajt przyjętych danych przy rocznym zobowiązaniu oraz 0,01 USD za gigabajt przeszukany zapytaniami. Wybór między wersjami zależy głównie od ilości danych i od tego, czy firma ma ludzi do utrzymania własnej instalacji.
Tak, OpenObserve przyjmuje dane w standardzie OpenTelemetry, czyli otwartym formacie zbierania logów, metryk i śladów żądań, niezależnym od dostawcy. Aplikacja wyposażona w biblioteki OpenTelemetry może wysyłać dane do OpenObserve bez zmian w kodzie, wystarczy wskazać nowy adres w konfiguracji kolektora. To ułatwia zmianę narzędzia w przyszłości, bo dane nie są związane z zamkniętym agentem jednego producenta. Przykładowo firma może przez kilka tygodni wysyłać te same dane równolegle do Datadog i OpenObserve, porównując oba systemy na prawdziwym ruchu. Zakres zmian zależy od tego, czy aplikacje już korzystają z OpenTelemetry, czy z własnych agentów dotychczasowego dostawcy.
Koszt utrzymania OpenObserve na własnych serwerach składa się z trzech części: serwerów obliczeniowych, magazynu obiektowego na dane i czasu zespołu. Serwery odpowiadają za przyjmowanie danych i zapytania, więc ich liczba rośnie razem z ilością logów i liczbą osób, które jednocześnie przeszukują dane. Magazyn obiektowy, na przykład Amazon S3, jest zwykle najtańszą częścią, bo dane są mocno skompresowane, a gigabajt w takim magazynie kosztuje ułamek ceny dysku SSD. Najtrudniej przewidzieć czas zespołu: przy małej instalacji to kilka godzin w miesiącu na aktualizacje i alerty, przy dużej, rozproszonej na wiele serwerów, część etatu. Łączny koszt zależy przede wszystkim od dziennej ilości danych, czasu ich przechowywania i wymagań dotyczących dostępności.
Tak, OpenObserve można podłączyć do Grafany i dalej korzystać z istniejących dashboardów. Metryki są dostępne przez język zapytań PromQL, ten sam, którego używa Prometheus, więc wiele paneli działa po zmianie źródła danych. Dla logów i śladów dostępna jest wtyczka OpenObserve do Grafany. Dzięki temu zespół, który zna Grafanę, nie musi od razu przenosić się do interfejsu OpenObserve, a migracja może przebiegać stopniowo. Ilość pracy zależy od tego, jak bardzo obecne dashboardy korzystają z funkcji specyficznych dla dotychczasowego źródła danych, na przykład zapytań w języku Kibany czy Datadoga.
Migracja trwa zwykle od kilku tygodni przy kilku usługach do kilku miesięcy w rozbudowanych systemach. Samo uruchomienie OpenObserve i skierowanie do niego pierwszych danych to kwestia dni, zwłaszcza gdy aplikacje korzystają z OpenTelemetry albo kolektorów takich jak Fluent Bit. Najwięcej czasu zajmuje odtworzenie dashboardów i alertów oraz okres równoległego działania obu systemów, potrzebny do sprawdzenia, że nowe alerty reagują na prawdziwe problemy. Przejście z własnego klastra Elasticsearch bywa prostsze, bo OpenObserve przyjmuje dane przez API zgodne z Elasticsearch. Czas zależy od liczby usług, liczby alertów i od tego, czy przy okazji zespół porządkuje, które dane w ogóle warto zbierać.
Tak, historyczne logi można przenieść z Elasticsearch do OpenObserve, ale w praktyce rzadko się to opłaca. Technicznie dane eksportuje się z indeksów Elasticsearch i wysyła do OpenObserve przez interfejs zgodny z Elasticsearch, na przykład przy pomocy Logstash. Większość firm zamiast tego trzyma stary klaster w trybie tylko do odczytu przez okres, w którym historyczne logi mogą być potrzebne, a nowe dane od razu zbiera w OpenObserve. Po upływie typowej retencji, na przykład 30 lub 90 dni, stary klaster można wyłączyć. Przeniesienie ma sens wtedy, gdy logi trzeba przechowywać długo, na przykład przez rok, a utrzymywanie starego klastra kosztuje więcej niż jednorazowy import.
W złożonych systemach IT, scentralizowany monitoring i debugging staje się wyzwaniem. Śledzenie rozproszone (Distributed Tracing) umożliwia lepsze zrozumienie jak dane przepływają przez mikrousługi. Jest to klucz do efektywnego zarządzania i ulepszania architektury IT.
Prometheus, powszechnie używany system monitorowania open-source, oferuje narzędzia umożliwiające śledzenie wydajności systemów. Prawidłowy monitoring jest kluczowy dla skutecznego zarządzania infrastrukturą IT, zapewniając jej nieprzerwaną dostępność oraz optymalizację zasobów.
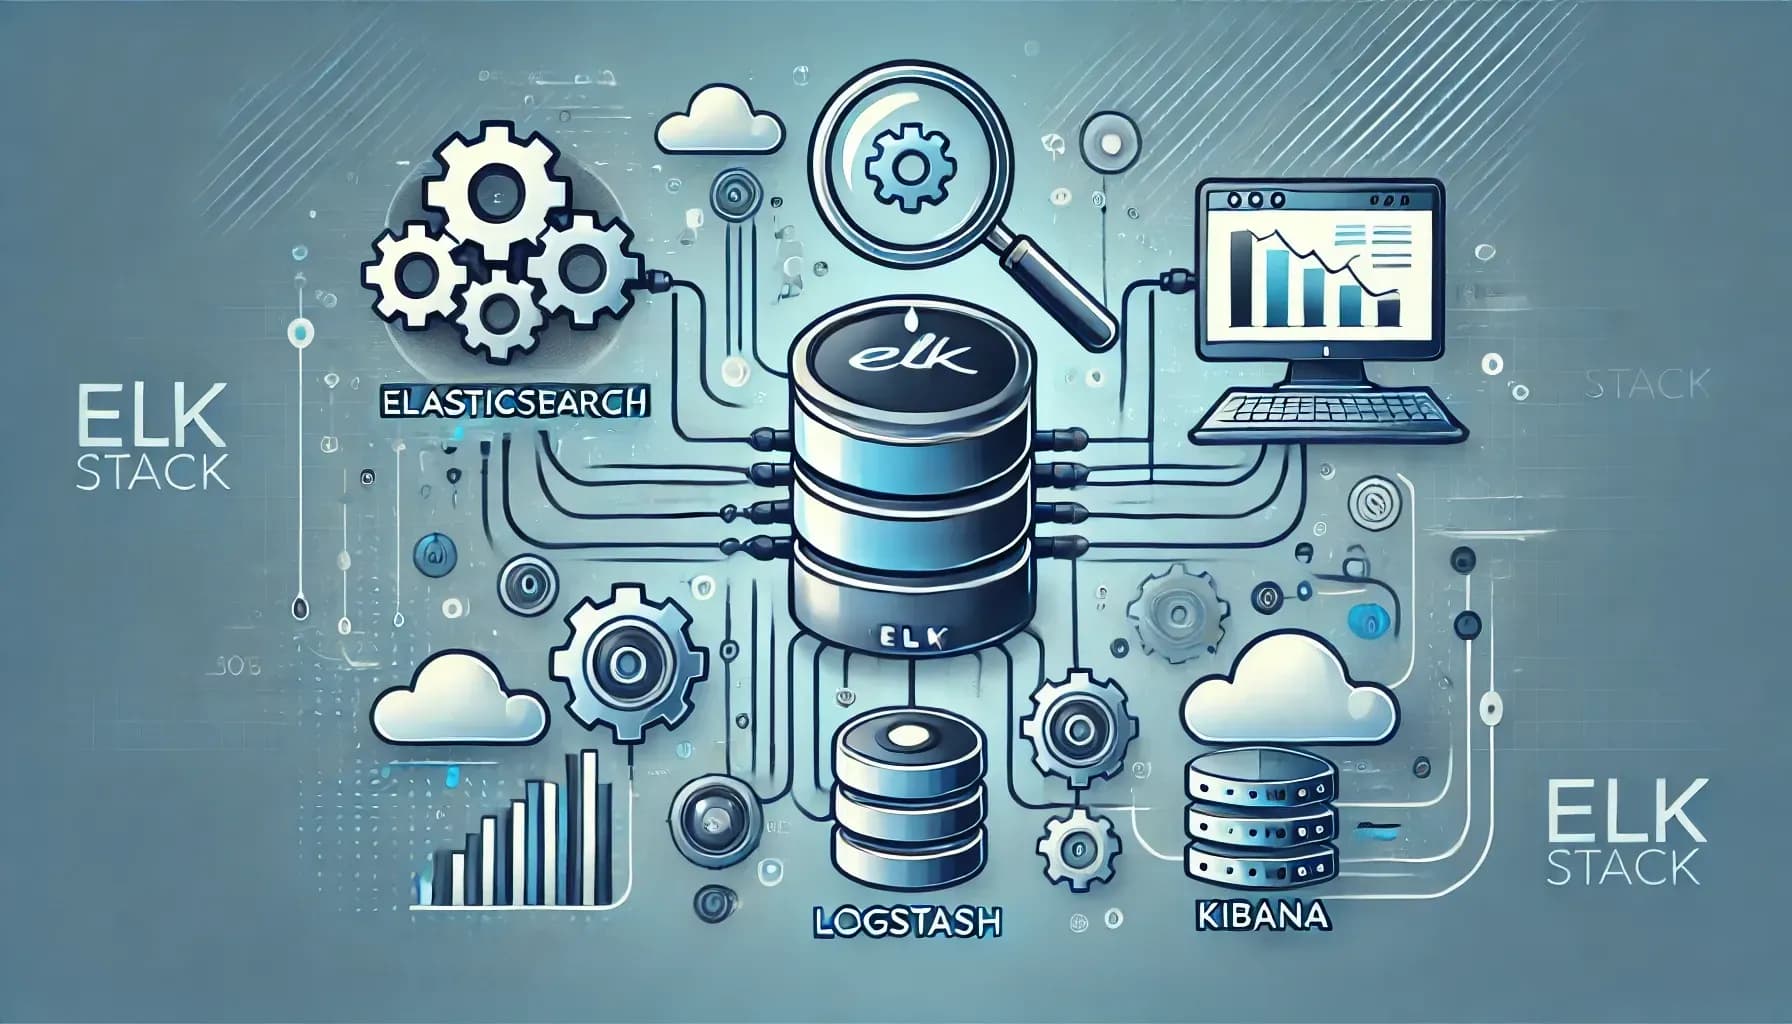
ELK Stack to zestaw opensourcowych narzędzi służący do analizy dużych ilości danych. W skład tego pakietu wchodzą: Elasticsearch do przeszukiwania, Logstash do centralizacji strumieni danych oraz Kibana do wizualizacji danych. Dzięki ELK Stack, możliwe jest gromadzenie, analiza, monitoring i wizualizacja danych w czasie rzeczywistym.
Amazon CloudWatch to narzędzie do monitorowania wydajności aplikacji w chmurze, oferujące szereg możliwości, takich jak zbieranie i analizowanie metryk, logów oraz alarmowanie na bazie danych. Dzięki niemu możemy w czasie rzeczywistym monitorować stan naszych zasobów i identyfikować problemy, co ma kluczowe znaczenie w środowiskach produkcyjnych.
SRE (Site Reliability Engineering) to innowacyjna koncepcja w dziedzinie IT, która powstała w Google, a która teraz zdobywa popularność na całym świecie. Stanowi ona klucz do zapewnienia niezawodności Twojej strony. SRE łączy umiejętności programistyczne z wiedzą operacyjną, aby zoptymalizować niezawodność i wydajność strony internetowej.
W świecie chmur obliczeniowych, zarządzanie aplikacjami to istotne wyzwanie. Helm, zwany 'The Kubernetes Package Manager', to narzędzie, które wprowadza nową jakość w administrowaniu aplikacjami w środowisku Kubernetes. Pozwala efektywnie zarządzać cyklem życia aplikacji, co stanowi klucz do skutecznego wdrażania i monitorowania systemów.